


论文阅读 IEEE TPAMI 2025 Probing Synergistic High-Order Interaction for Multi-Modal Image Fusion
TPAMI 2025 | Probing Synergistic High-Order Interaction for Multi-Modal Image Fusion
01 论文信息
- 论文题目: Probing Synergistic High-Order Interaction for Multi-Modal Image Fusion
- 论文作者: Man Zhou,Naishan Zheng,Xuanhua He,Danfeng Hong,Jocelyn Chanussot
- 发表单位: Man Zhou(中国科学院空天信息创新研究院);Naishan Zheng、Xuanhua He(中国科学技术大学);Danfeng Hong(中国科学院空天信息创新研究院、中国科学院大学);Jocelyn Chanussot(Inria、CNRS、格勒诺布尔理工学院)
- 发表会议\期刊: IEEE Transactions on Pattern Analysis and Machine Intelligence(TPAMI),2025(Vol. 47, No. 2, February 2025)
- 论文链接:https://ieeexplore.ieee.org/document/10706703
- 代码链接: https://github.com/zheng980629/SHIP
02 论文主要贡献
本文针对多模态图像融合中现有方法主要建模低阶或局部交互、难以充分挖掘多源模态协同关系的问题,系统研究了空间与通道两个维度的高阶交互。
结合摘要和引言,论文的主要贡献可概括为:它把多模态融合从常见的二阶注意力关系扩展到可迭代的高阶空间和通道关系建模,使模型能够在细粒度空间结构和全局统计依赖上同时聚合互补信息;扩展版 SHIP++ 进一步增强了跨阶信息利用和注意力演化能力。实验结果覆盖红外-可见光融合与全色锐化两类任务,证明高阶交互机制能提升融合质量和跨任务泛化性。
03 论文创新点
- 首次在多模态图像融合中探索高阶交互;通过在空间与通道维度引入高阶交互,提出协同高阶交互范式(SHIP),用于研究多模态之间的协同相关性。
- 该范式深入挖掘涉及空间细粒度信息与全局统计信息的高阶交互,协同聚合互补信息,并区分多个源模态之间的相互依赖关系。
- 通过定量与定性实验,证明所提出的 SHIP++ 在多模态图像融合任务中的优越性。
04 方法
4.1 整体框架
SHIP的整体框架以交替执行空间和通道高阶交互为核心,通过L次迭代完成多模态特征的协同聚合与依赖区分,整体流程适用于红外与可见光图像融合、全色锐化两大任务,仅在输入模态和最终输出层存在细微差异。
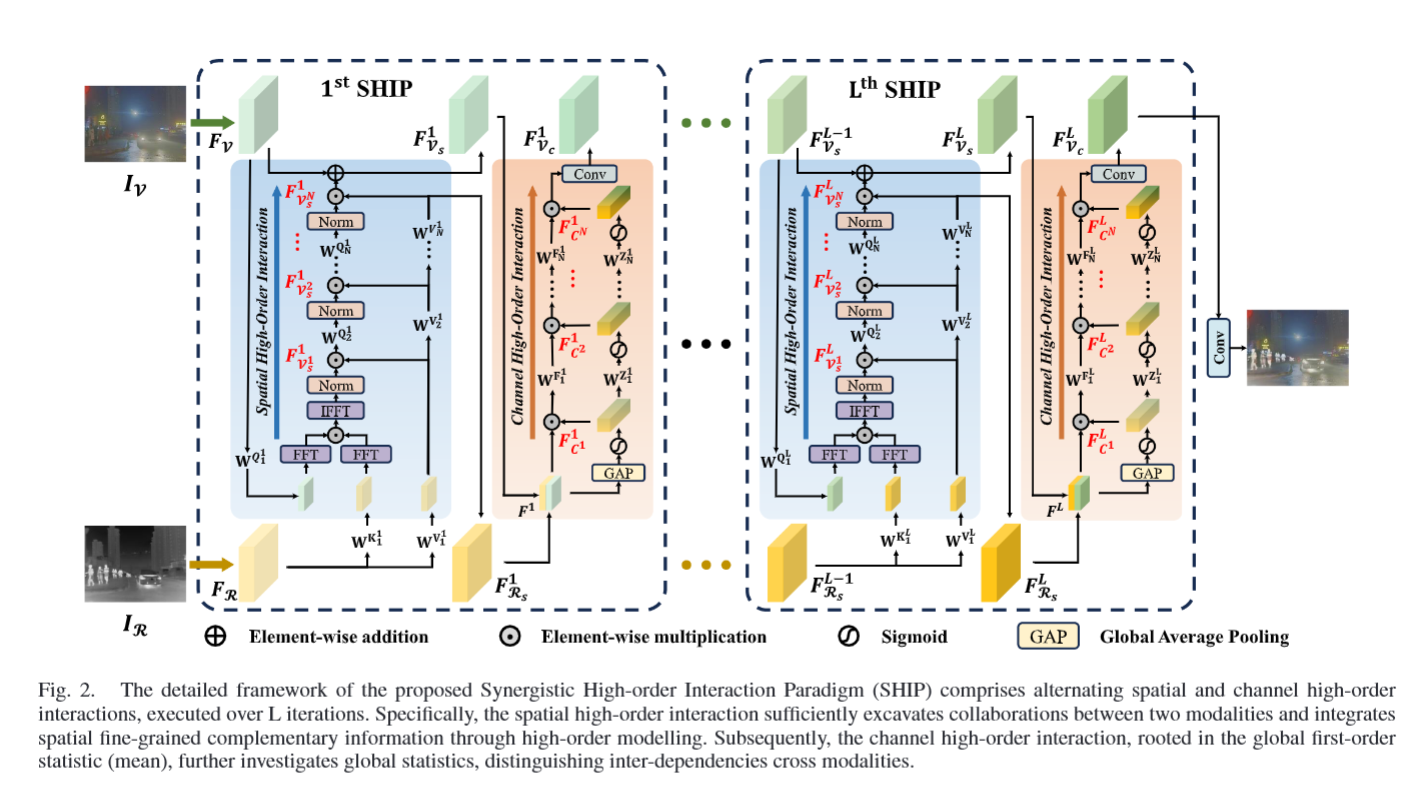
- 特征提取:对不同模态的输入图像分别通过独立的卷积层提取浅层模态感知特征和;
- 高阶交互迭代:将提取的特征输入SHIP核心模块,交替执行N阶空间高阶交互和N阶通道高阶交互,共进行L次迭代,充分挖掘多模态间的空间细粒度关联和全局统计关联;
- 图像重建:将完成高阶交互的融合特征投影回图像空间,生成最终的融合图像。
整体范式的数学表达为:
- 红外与可见光图像融合:
- 全色锐化:
其中和为特征提取器,L为SHIP迭代次数,为红外/可见光图像,为全色/多光谱图像。
4.2 高阶空间交互
高阶空间交互的设计核心是将传统Transformer的二阶空间交互扩展为任意阶(N阶),同时通过频域变换降低计算复杂度,解决传统级联自注意力仅生成多二阶交互、计算开销大的问题,分为重新审视自注意力、等效高效形式、高阶形式探究三部分。
4.2.1 重新审视自注意力(传统二阶交互的局限)
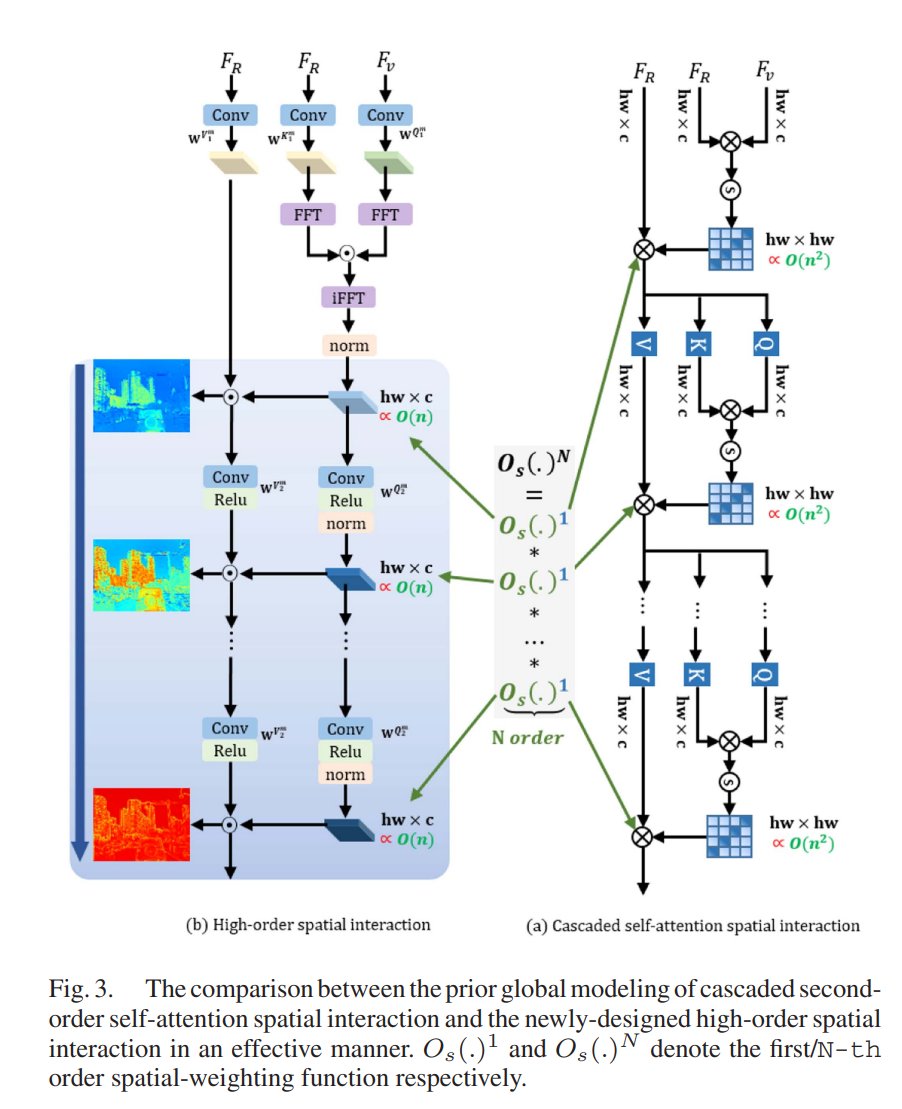
Transformer的自注意力机制是二阶空间交互的典型实现,其通过查询(Q)、键(K)、值(V)的矩阵乘法捕捉特征间的空间关联,对于VIF任务,Q/K/V的生成公式为:
其中,为线性变换矩阵,分别将可见光特征、红外特征投影到查询、键、值空间。
自注意力的二阶空间交互实现公式为:
其中,为键K的维度,为点积操作,为空间相关矩阵,表示捕捉到二阶空间交互的输出特征。
核心局限:①矩阵乘法为二次时间复杂度,直接级联会带来巨大计算开销;②级联自注意力仅能生成多个二阶交互,无法实现真正的高阶建模,难以挖掘深层空间关联。
4.2.2 等效高效形式(频域变换降低计算复杂度)
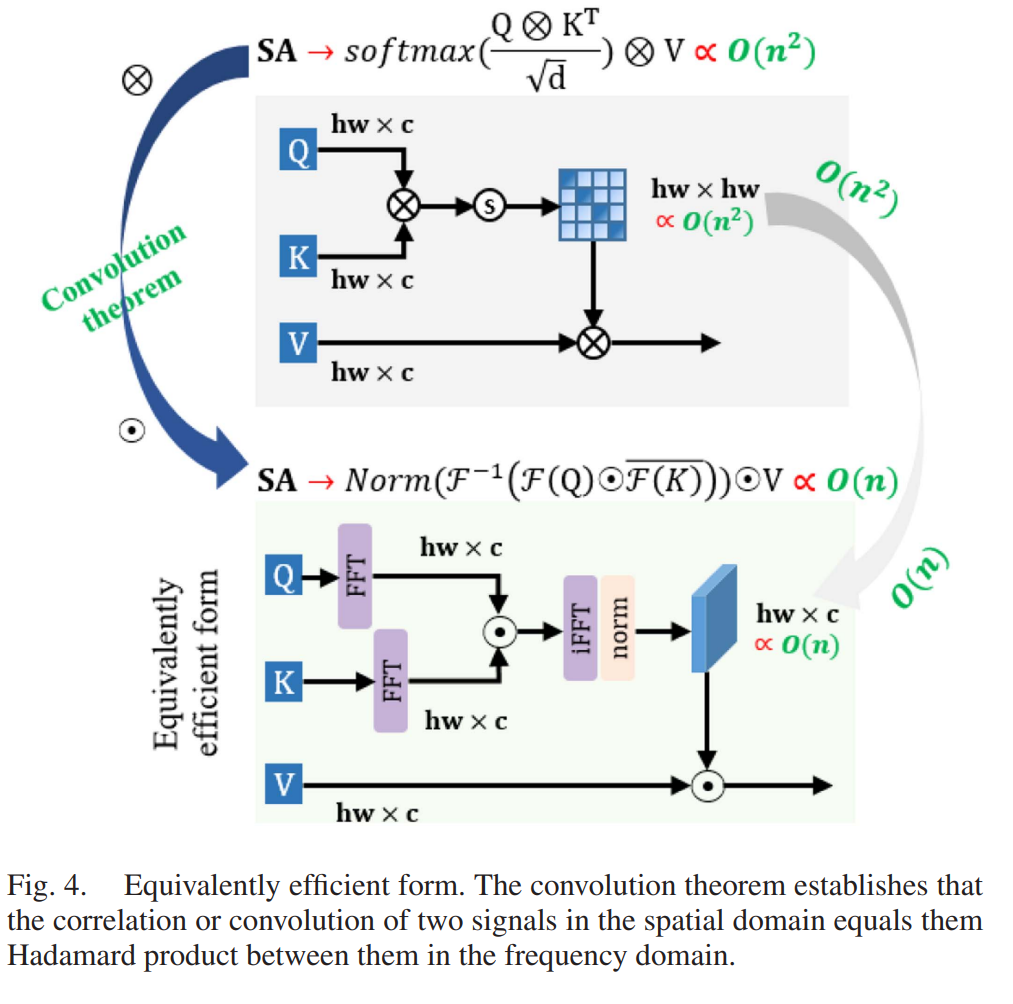
利用卷积定理(空间域的相关/卷积操作 ≡ 频域的哈达玛积操作),将自注意力中的矩阵点积转化为频域逐元素乘法,大幅降低计算复杂度,同时保持空间关联捕捉的有效性。
第一步:将模态特征通过快速傅里叶变换(FFT)映射到频域,计算频域相关矩阵:
其中,为FFT变换,为逆FFT变换,为哈达玛积(逐元素乘法),为频域特征的共轭转置。
第二步:通过层归一化(Norm)和哈达玛积得到二阶空间交互的等效高效特征:
该形式将矩阵乘法的二次复杂度转化为FFT的复杂度,在高分辨率特征处理中计算效率提升显著。
4.2.3 高阶形式探究(N阶空间交互的实现)
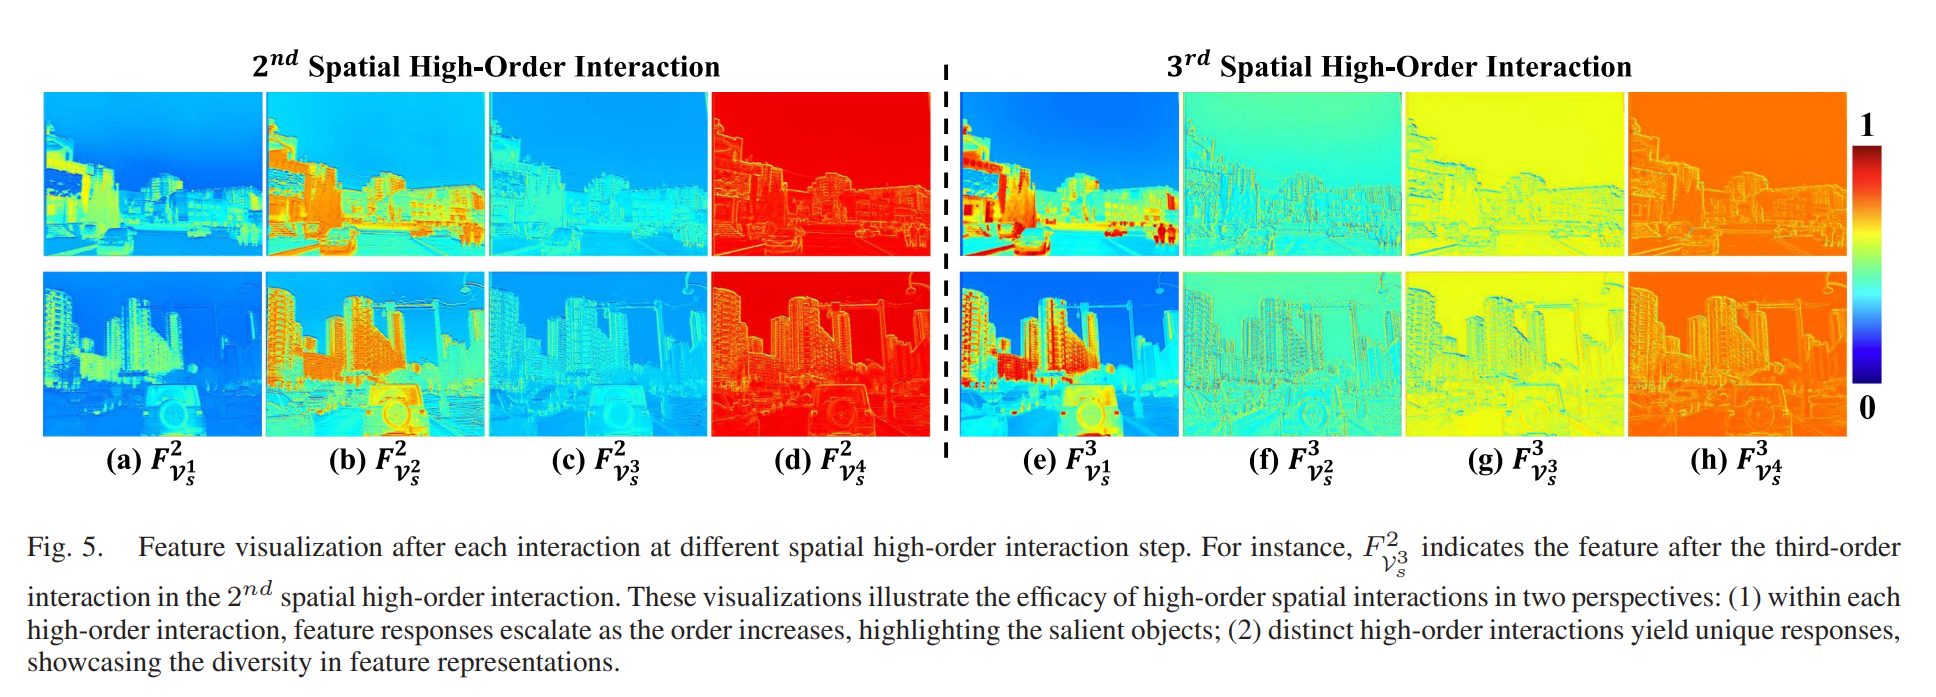
在频域等效形式的基础上,通过迭代聚合互补信息将二阶空间交互扩展为任意N阶,实现真正的高阶空间建模,核心公式为:
其中,(j为当前阶数),(i为当前迭代次数),为第i次迭代、第j阶的线性变换矩阵。
传统级联自注意力的特征演化仅为多二阶交互:
而SHIP的高阶空间交互为每次迭代均实现N阶交互:
核心优势:不同阶数的空间交互能捕捉不同粒度的互补特征模式,高阶特征能更精准地突出显著目标,提升特征表示的多样性。
4.3 高阶通道交互
高阶通道交互以Squeeze-and-Excitation (SE)块为基础,将SE块基于一阶全局统计(均值)的一阶通道交互扩展为N阶高阶形式,实现对多模态全局统计层面深层依赖的挖掘,分为重新审视SE块、高阶形式探究两部分。
4.3.1 重新审视SE块(传统一阶通道交互的局限)
SE块是一阶通道交互的典型实现,其通过全局均值池化提取一阶统计特征,实现通道响应的自适应校准,对于VIF任务的第i次空间高阶交互输出特征,SE块的实现公式为:
其中,为第i次空间交互后的双模态特征拼接结果,为一阶全局统计特征(均值),为Sigmoid激活函数,包含两层线性变换+ReLU激活,为逐元素乘法,为一阶通道交互的输出特征。
核心局限:仅基于一阶统计(均值)捕捉通道浅层依赖,无法挖掘多模态间基于高阶全局统计的深层通道关联,对模态间依赖的辨别能力不足。
4.3.2 高阶形式探究(N阶通道交互的实现)
在SE块的基础上,通过迭代计算高阶统计特征和通道校准,将一阶通道交互扩展为N阶高阶形式,实现对多模态深层通道依赖的捕捉,核心公式为:
其中,(j为当前阶数),(i为当前迭代次数),为第i次迭代、第j阶的线性变换矩阵,为第j-1阶全局统计特征,为第j-1阶通道校准特征。
最终,通过卷积层将N阶通道交互的输出特征整合为融合模态特征,进入下一次迭代的空间高阶交互。
4.3.3 空间-通道高阶交互链
通过L次迭代的N阶空间+通道高阶交互,形成完整的双维度高阶交互链,实现多模态特征的逐层优化,核心公式为:
4.4 SHIP++的核心改进模块
SHIP++在SHIP基础上,针对主模态信息丢失、不同阶数特征互补、注意力图精准性不足三大问题,设计**残差信息记忆(RIM)、跨阶信息整合(COII)、跨阶注意力演化(COAE)**三大核心机制,进一步提升跨模态信息交互能力,所有机制均适配VIF和全色锐化两大任务。
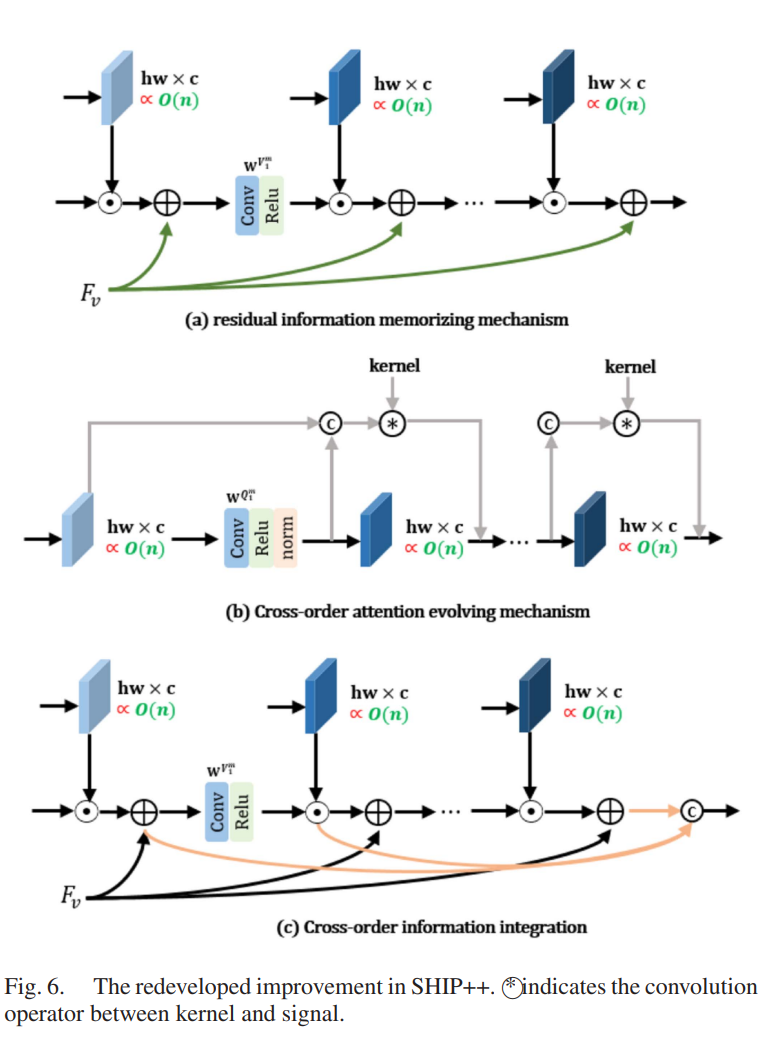
4.4.1 残差信息记忆(Residual Information Memorizing, RIM)
设计背景:VIF中的可见光图像、全色锐化中的多光谱图像为主模态,包含任务所需的核心信息,但传统迭代过程中主模态特征易被覆盖,导致细节丢失。 核心思路:通过残差连接将主模态原始特征与迭代过程中的特征融合,在每次迭代中保留主模态关键信息。 数学公式:
其中,为第i-1次迭代、第j阶的主模态特征,为主模态原始特征,Conv为卷积层(用于特征融合与维度匹配)。
4.4.2 跨阶信息整合(Cross-Order Information Integration, COII)
设计背景:不同阶数的空间高阶交互能捕捉多样化的互补特征模式(Fig.5),单独使用某一阶特征会损失信息丰富度。 核心思路:将同一迭代中所有阶数的空间高阶特征进行拼接与卷积融合,整合多样化互补特征,生成更具信息量的融合特征。 数学公式:
其中,为第i次迭代中1~N阶的空间高阶特征,concat为通道维度拼接,Conv为卷积层(用于特征整合)。
4.4.3 跨阶注意力演化(Cross-Order Attention Evolving, COAE)
设计背景:传统注意力图各层独立学习,无知识共享,浅层注意力无法引导深层注意力,导致深层注意力对关键特征的捕捉精度不足。 核心思路:借鉴注意力演化机制,通过残差连接实现不同阶数/层注意力图的知识共享,让浅层注意力引导深层注意力的学习,提升注意力图的精准性。 数学公式:
其中,为第i次迭代、第j阶的注意力图,为第j-1阶的注意力图,为当前阶的查询特征,concat为通道拼接,Norm为层归一化。
核心效果:注意力图从浅层到深层逐步精准,能更清晰地突出多模态的关键特征(如VIF中的行人/车辆、全色锐化中的地物纹理)。
4.5 损失函数设计
针对VIF和全色锐化两大任务的核心需求,设计任务专属的损失函数,引导模型学习贴合任务特性的融合特征,避免通用损失函数的局限性。
4.5.1 全色锐化任务:L1损失
任务需求:提升融合图像的空间分辨率和光谱保真度,让融合图像尽可能接近真实高分辨率多光谱图像(GT)。 损失公式:
其中,为网络输出的融合图像,GT为真实高分辨率多光谱图像,为L1范数(像素级误差)。
4.5.2 红外与可见光融合(VIF)任务:强度损失+梯度损失
任务需求:同时保留红外图像的显著目标和可见光图像的精细纹理,融合图像符合人类视觉感知。 整体损失:,其中为权衡参数,平衡强度损失和梯度损失的权重。
4.5.2.1 (1)显著性感知的强度损失()
核心思路:基于红外/可见光图像的显著性图设计加权系数,让融合图像更贴合双模态的显著区域,突出红外目标的同时保留可见光的亮度特征。 损失公式:
其中,为可见光/红外图像的加权图,为逐元素乘法,为L1范数;加权图由显著性矩阵S计算:,,S由[72]的显著性算法生成。
4.5.2.2 (2)最大梯度纹理损失()
核心思路:图像梯度代表纹理细节,通过Sobel算子计算双模态的梯度图,让融合图像的梯度图聚合双模态的最大梯度信息,保留最丰富的纹理细节。 损失公式:
其中,为Sobel算子的梯度计算操作,为逐元素取最大值,HW为图像像素总数,为L1范数。
05 实验分析
论文在红外与可见光图像融合(VIF)和全色锐化(pan-sharpening)两大任务上开展了全面的实验验证,包括SOTA方法对比、超参数消融实验、模块消融实验,采用定量指标+定性可视化+下游任务验证的方式,全方位验证SHIP/SHIP++的性能,并深入分析各模块/超参数的作用机理。
5.1 红外与可见光图像融合(VIF)实验
5.1.1 实验设置
- 数据集:
- 训练集:M3FD(4200对配对图像,3900对训练,300对官方测试);
- 跨数据集测试集:RoadScene、TNO(各随机选取25对,验证模型泛化性);
- 评价指标(所有指标值越高,融合效果越好): 空间频率(SF)、互信息(MI)、视觉信息保真度(VIF)、平均梯度(AG)、(边缘保持)、特征互信息(FMI)、SCD(显著目标保持);
- 实现细节: PyTorch框架、NVIDIA GTX 3090 GPU、Adam优化器()、30K迭代、批次大小8、初始学习率(每5K迭代衰减0.5)、特征补丁大小128×128。
5.1.2 SOTA对比分析
将SHIP/SHIP++与11种SOTA方法对比:DDcGAN、DenseFuse、AUIF、DIDFuse、ReCoNet、SDNet、TarDAL、U2Fusion、UMFusion、LRRNet、TIM,从定量指标、定性可视化、下游任务三方面验证性能优势。
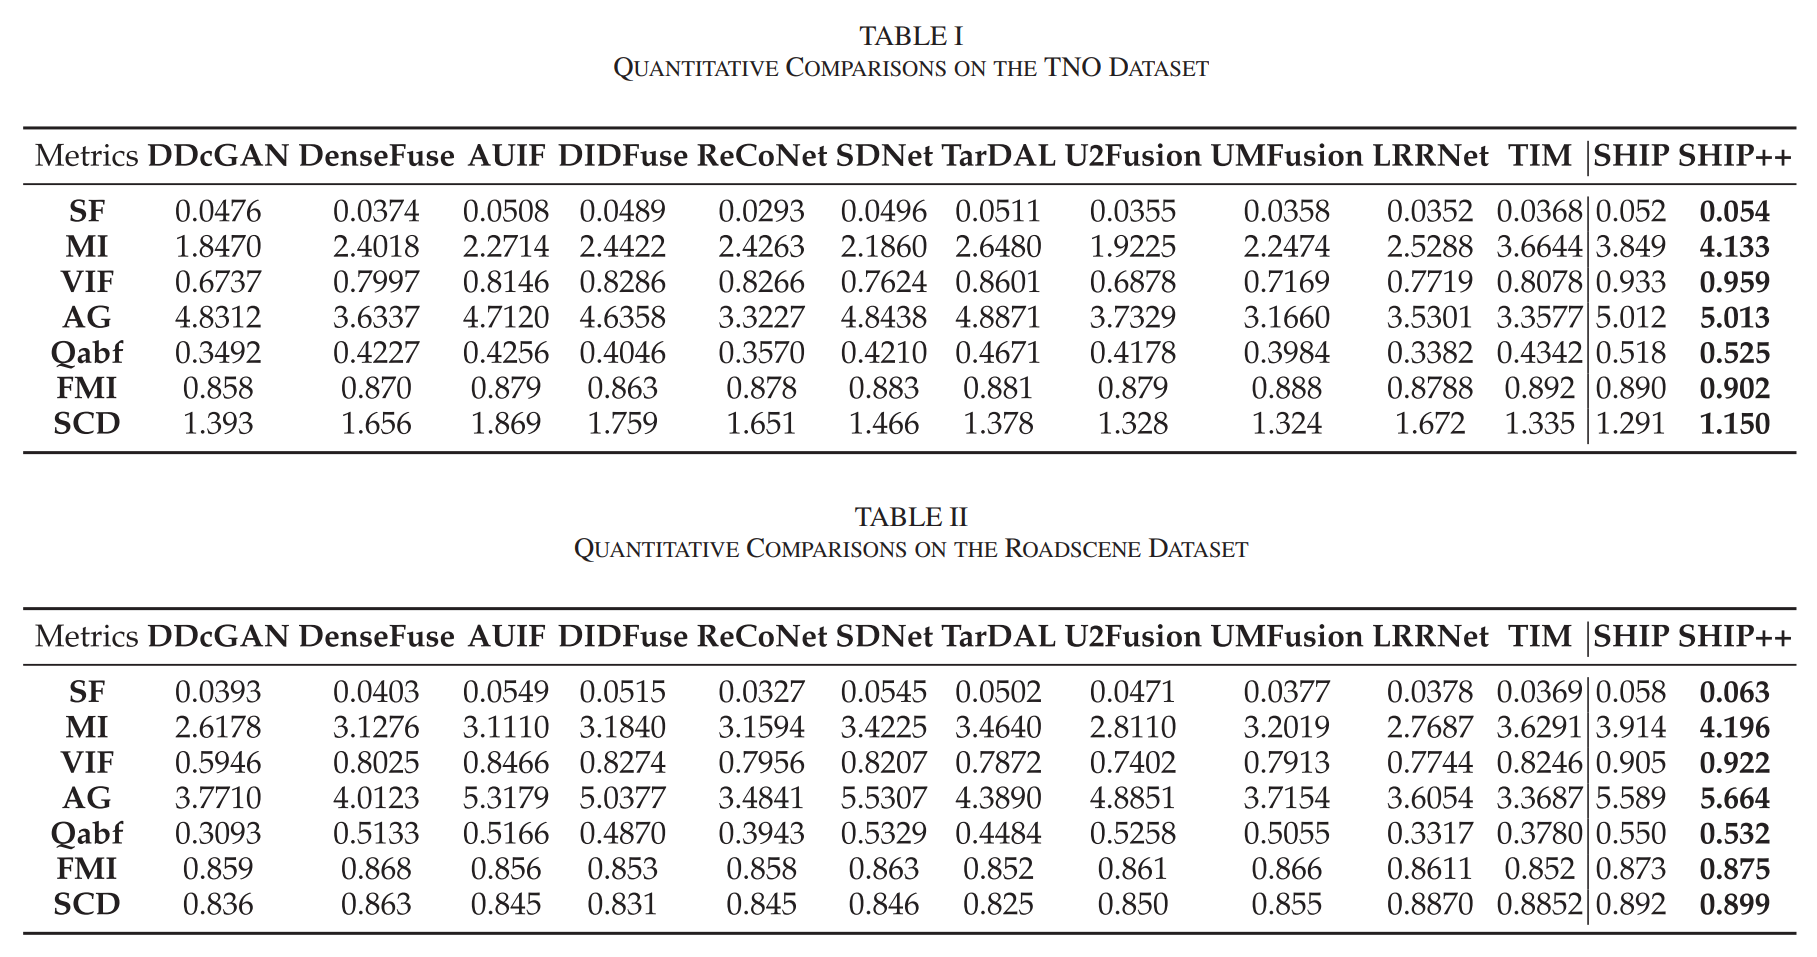
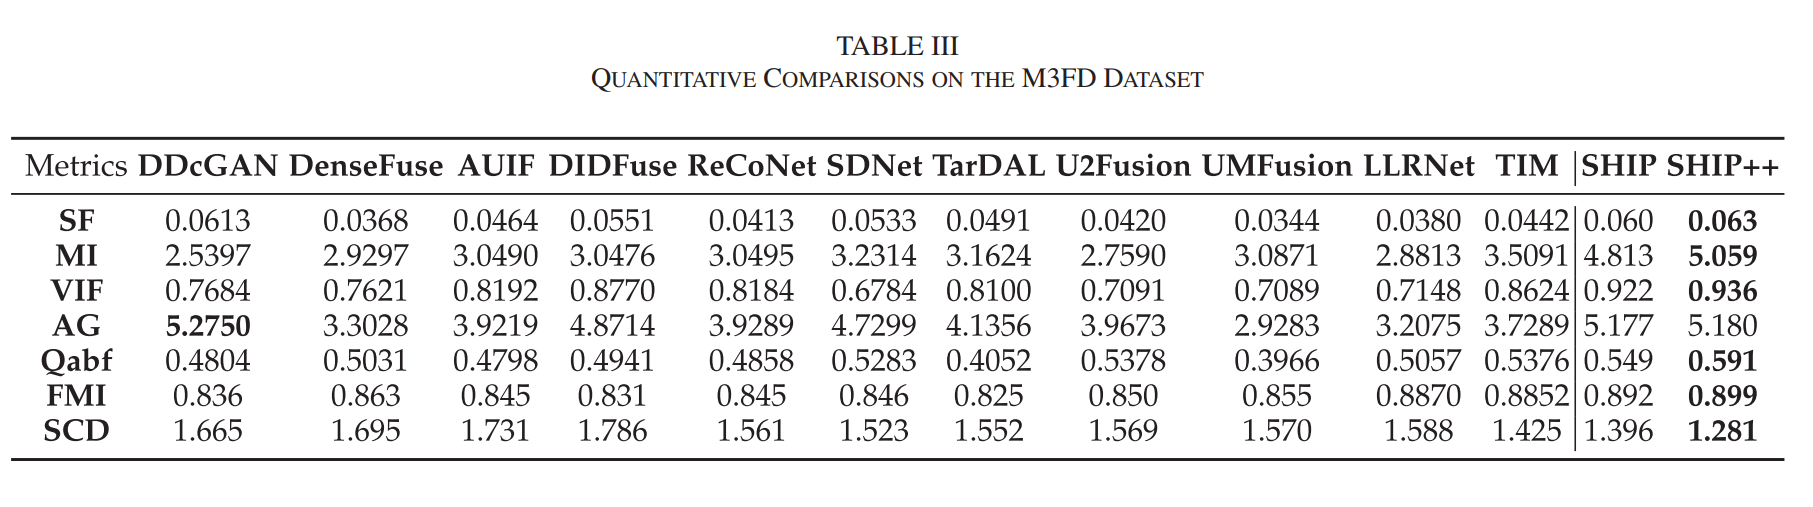
5.1.2.1 (1)定量结果
SHIP++在M3FD、RoadScene、TNO三个数据集的所有7项评价指标上均取得最优结果,核心优势体现在:
- MI/FMI指标显著高于其他方法:说明SHIP++能更充分地整合红外/可见光的互补信息,融合图像包含更丰富的多模态特征;
- SF/AG/指标最优:证明SHIP++能更好地保留可见光的精细纹理和边缘特征,融合图像的空间细节更丰富;
- VIF指标最高:表明融合图像的视觉质量更优、失真更小,更符合人类视觉感知;
- SCD指标最低(最优):说明SHIP++能更精准地保留红外图像的显著目标(如车辆、行人)。
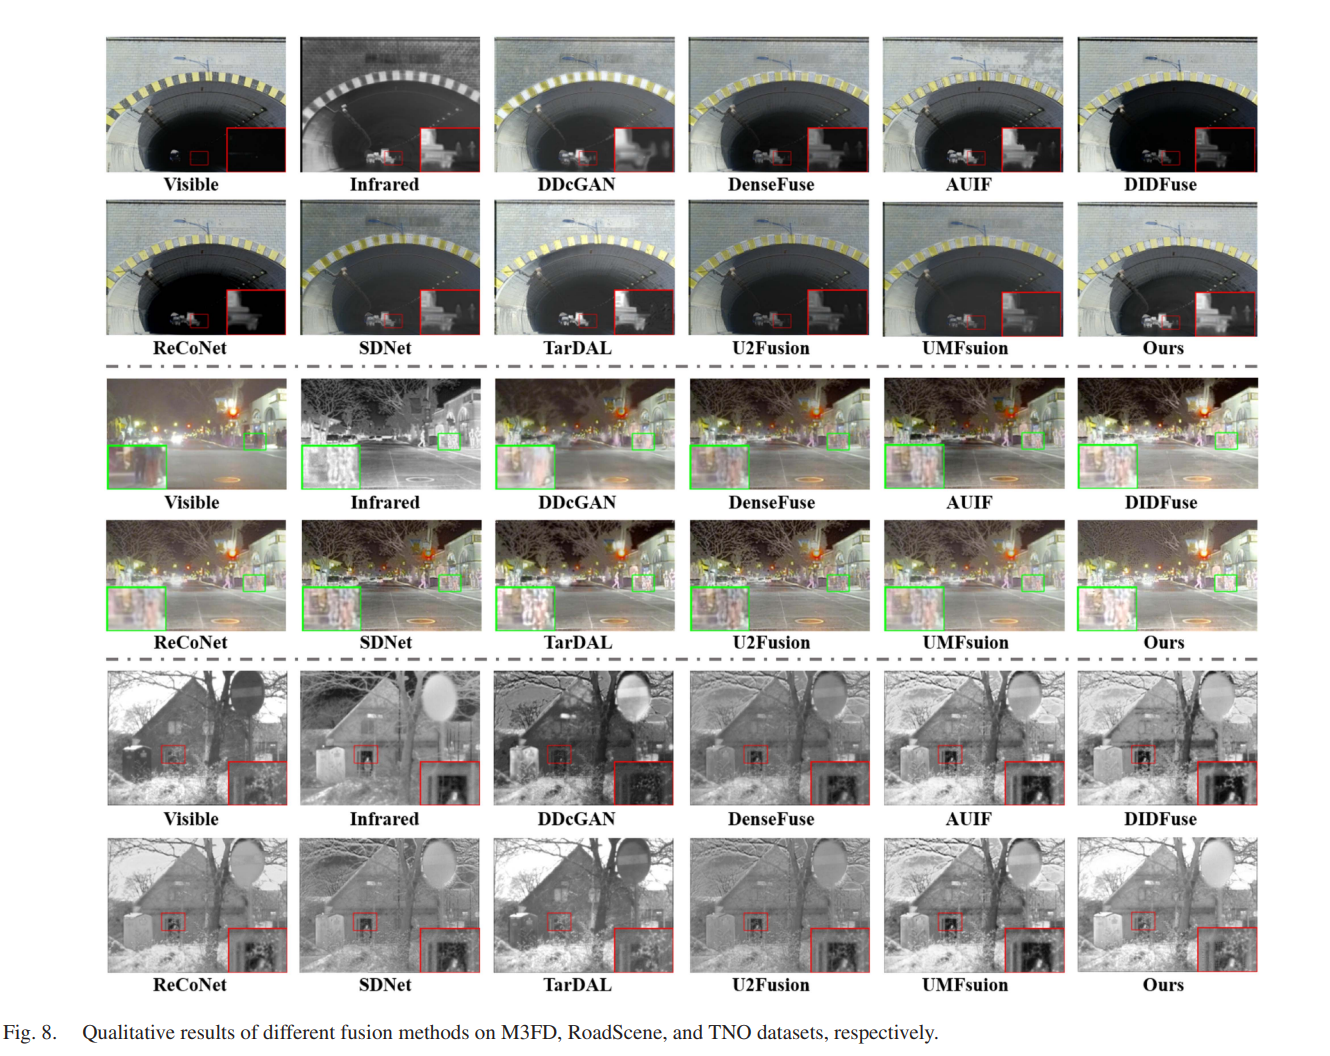
5.1.2.2 (2)定性结果
SHIP++的融合图像实现了「红外显著目标+可见光精细纹理」的完美平衡,核心优势:
- 显著目标突出:红外图像中的车辆、行人对比度高、轮廓清晰;
- 纹理细节丰富:可见光图像中的树叶、建筑、路面纹理保留完整;
- 视觉效果自然:无亮度失衡、模糊、伪影等问题。
对比其他方法的不足:
- DenseFuse/SDNet/U2Fusion:无法有效突出红外显著目标,融合图像对比度低;
- DDcGAN/ReCoNet:可见光纹理捕捉不足,融合图像模糊,存在伪影;
- DIDFuse:能捕捉红外热特征,但亮度偏低,视觉效果差。
5.1.2.3 (3)下游任务验证(目标检测)
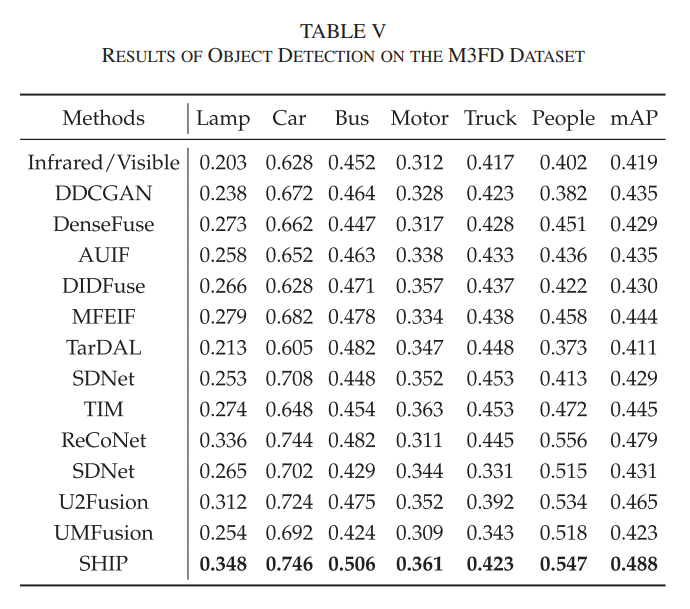
以FCOS为目标检测模型,在M3FD融合结果上进行目标检测(检测类别:灯、汽车、公交车、摩托车、卡车、行人),SHIP++的mAP指标达0.488,显著高于所有SOTA方法,证明其融合图像能为下游计算机视觉任务提供更有效的特征信息,具有实际应用价值。
5.1.3 消融实验
在M3FD数据集上开展消融实验,探究阶数N、迭代数L、空间-通道维度对模型性能的影响,确定最优超参数,并验证双维度交互的必要性。
5.1.3.1 (1)阶数N与迭代数L的消融
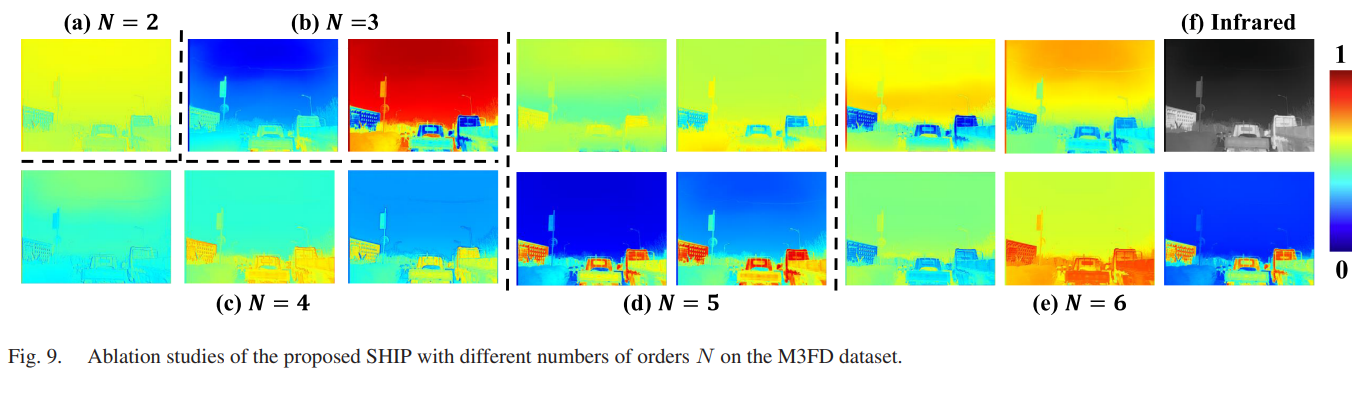
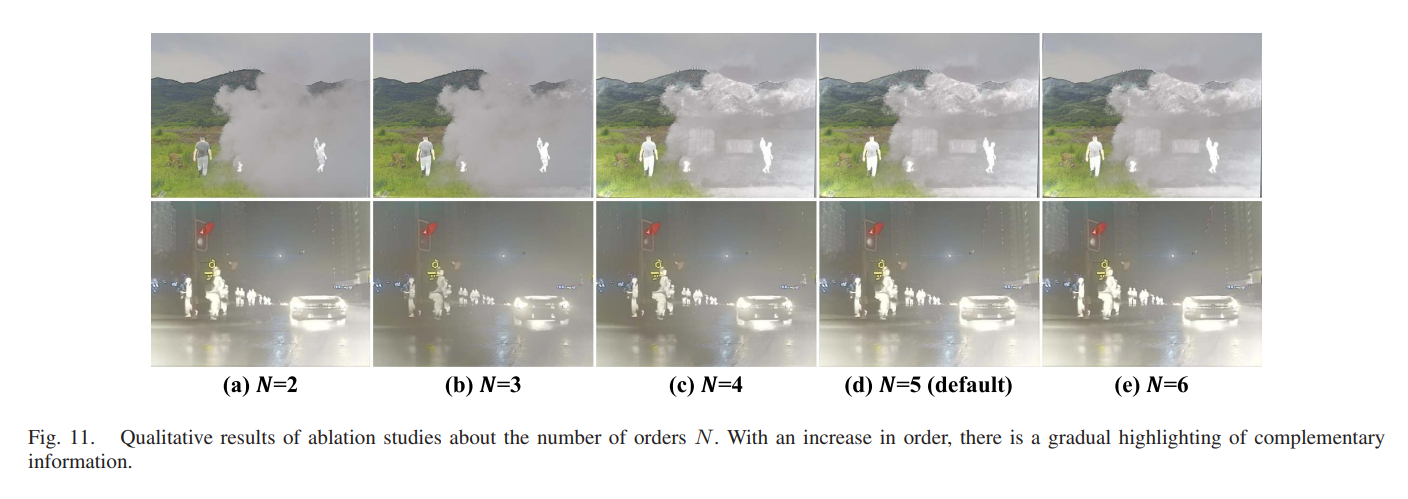
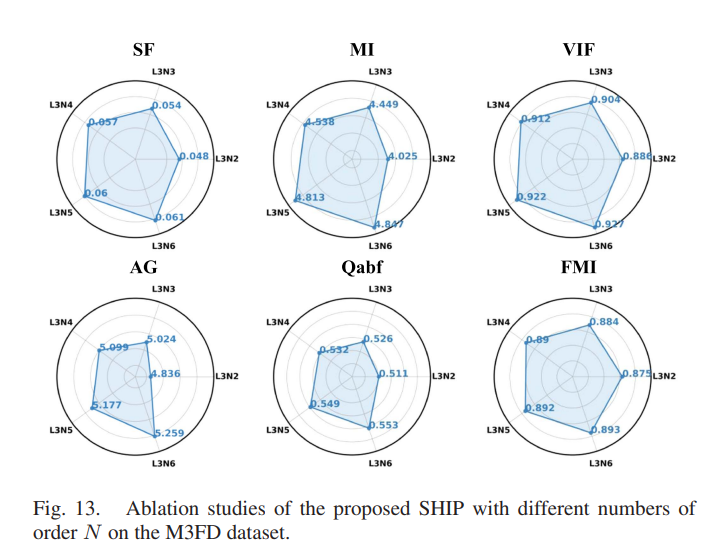
- 阶数N:模型性能随N增加逐步提升,N=5时性能趋于稳定(继续增加N无明显提升,且增加计算成本);不同N的特征可视化显示,阶数越高,显著目标的特征响应越强。
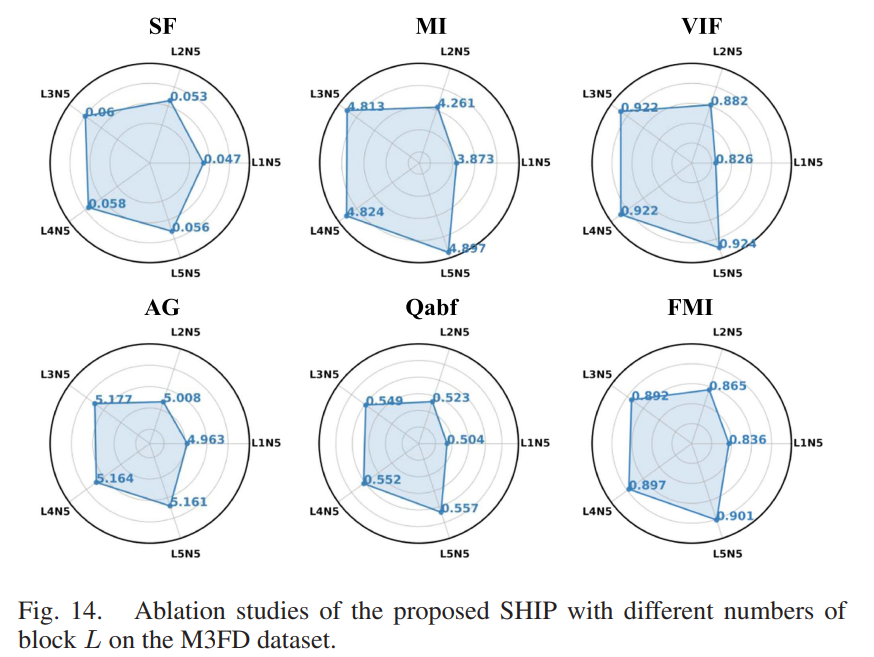
- 迭代数L:性能随L增加先提升后下降,L=3为最优;L过大时,梯度传播困难,导致SF/AG等纹理指标下降;不同L的定性结果显示,L越多,显著目标的轮廓越精准。
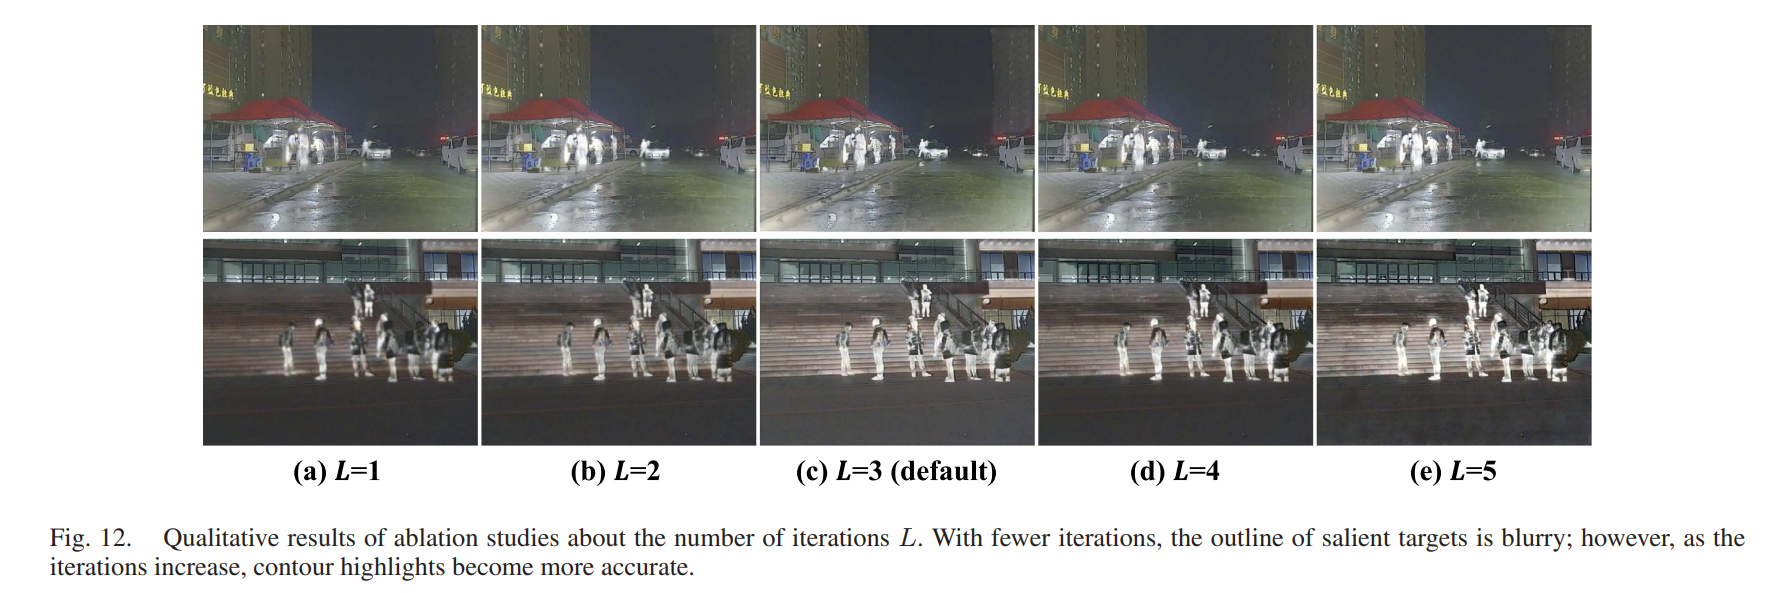
【插入Fig.12 迭代数L消融的定性结果图】 【插入Fig.14 迭代数L消融的定量曲线图】
5.1.3.2 (2)空间-通道维度的消融
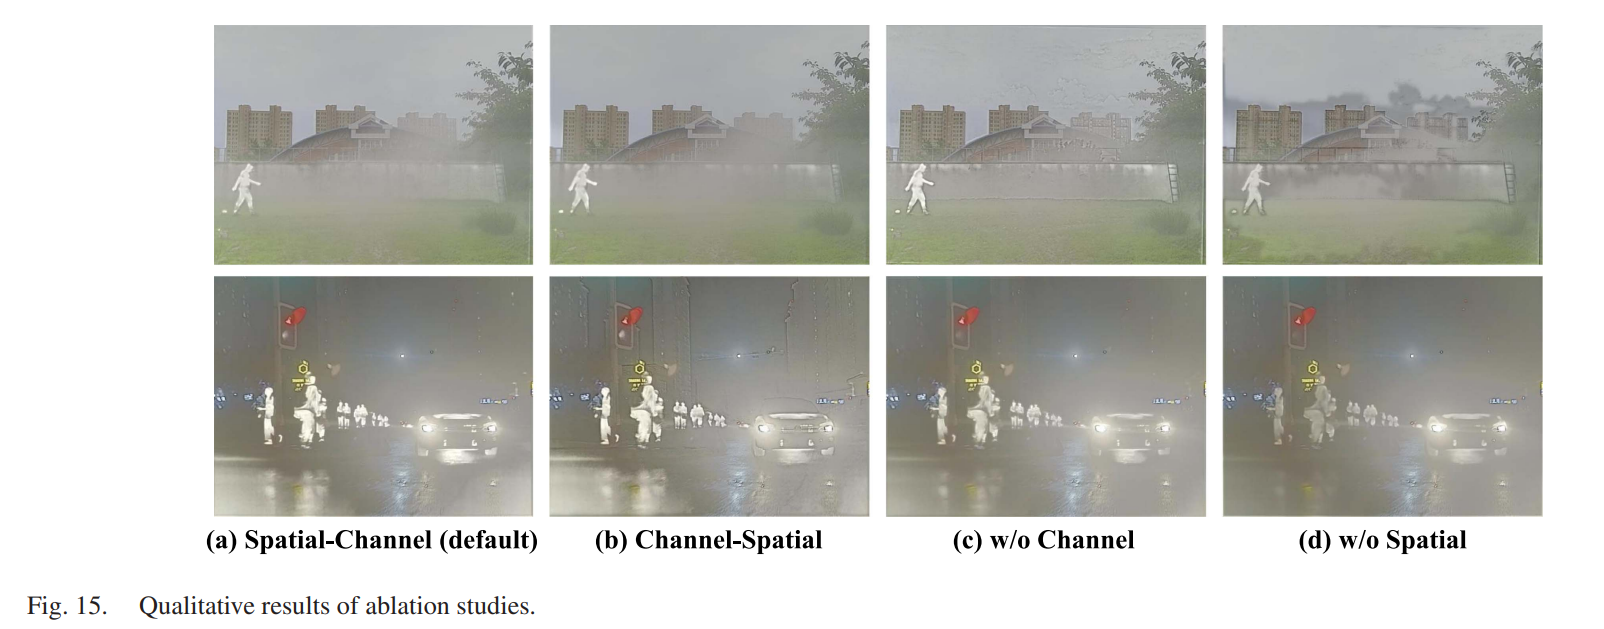
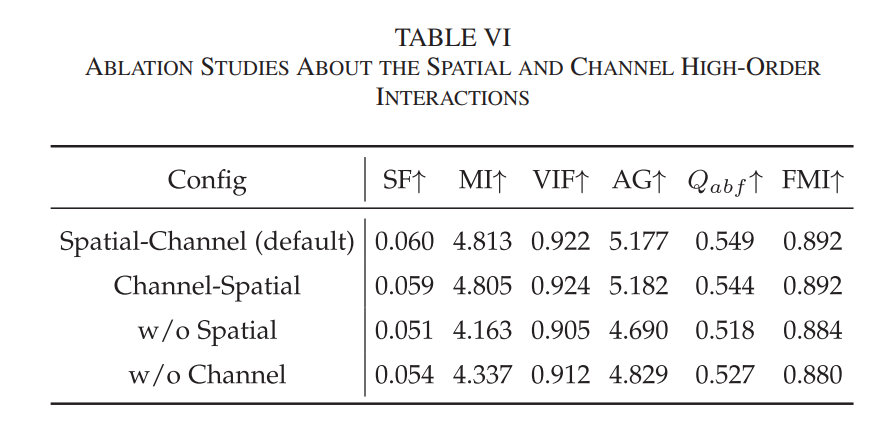
验证空间/通道高阶交互的必要性和执行顺序的鲁棒性,设置4种配置:①空间-通道(默认);②通道-空间;③无空间;④无通道,核心结论:
- 双维度交互缺一不可:移除空间/通道任一维度,模型性能显著下降(SF/MI/VIF等指标大幅降低),定性结果显示融合图像亮度失衡、细节丢失;
- 执行顺序鲁棒:空间-通道/通道-空间的执行顺序对性能影响极小,验证了SHIP高阶交互机制的鲁棒性。
5.2 全色锐化(pan-sharpening)实验
5.2.1 实验设置
- 数据集:Worldview-II、Worldview-III、高分2号(Gaofen2),包含全分辨率测试集(验证模型在真实高分辨率场景的泛化性);
- 评价指标:
- 越高越好:PSNR(峰值信噪比)、SSIM(结构相似性)、SCC(相关系数)、QNR(综合质量);
- 越低越好:SAM(光谱角映射)、ERGAS(相对无维全局误差)、(光谱失真)、(空间失真);
- 实现细节: Adam优化器、1000轮训练、批次大小4、初始学习率(200轮后衰减0.5);因无真实标签,采用Wald协议构建训练数据集(将高分辨率MS图像下采样为LRMS,作为模型输入);PAN补丁大小128×128,MS补丁大小32×32。
5.2.2 SOTA对比分析
将SHIP/SHIP++与传统方法(SFIM、GS、Brovey、IHS、GFPCA)和深度学习SOTA方法(PNN、PANNet、MSDCNN、SRPPNN、GPPNN、INNformer、MutNet、SFINet、GSFL、CANL)对比,核心结论:
5.2.2.1 (1)定量结果
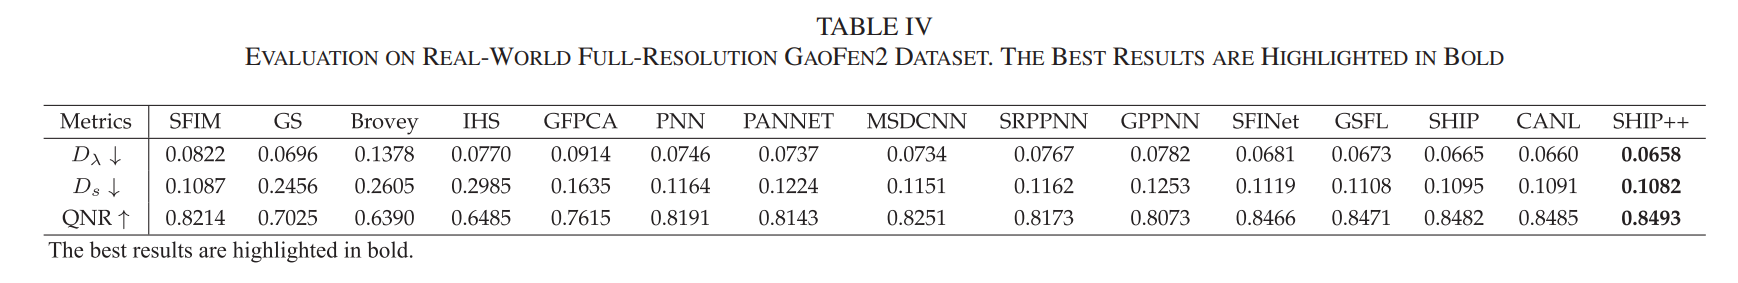
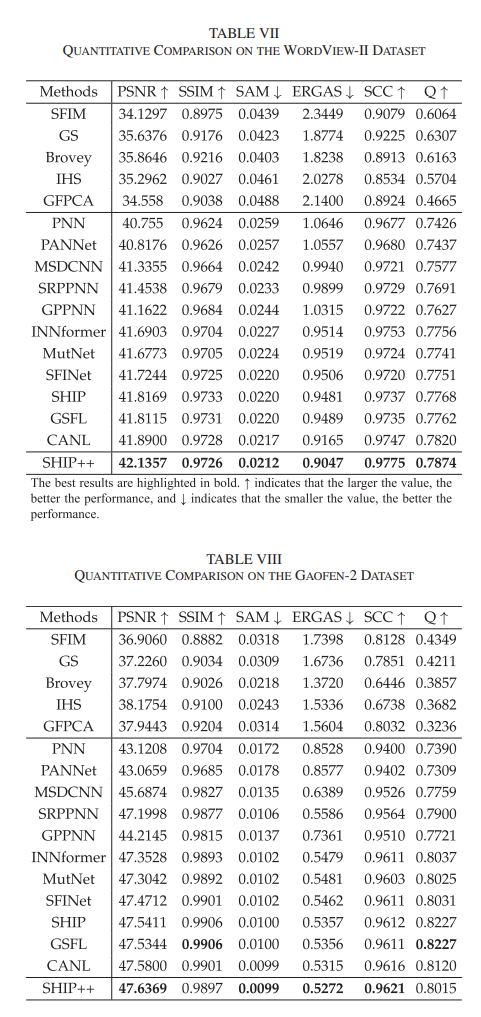
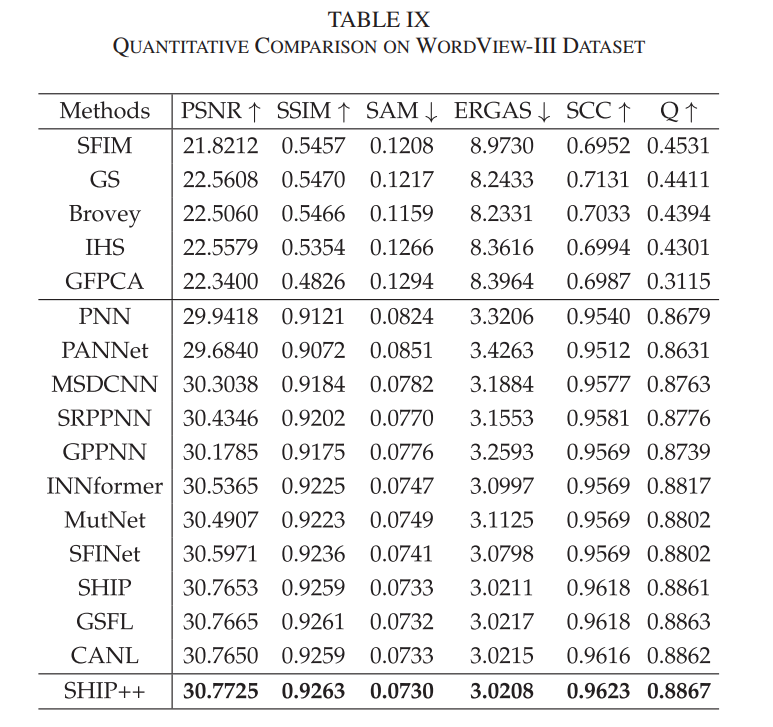
SHIP++在三个卫星数据集的所有评价指标上均实现最优,核心优势:
- PSNR/SSIM/SCC/QNR指标最高:说明SHIP++的融合图像空间分辨率高、结构相似性好,与真实标签的贴合度最高;
- SAM/ERGAS//指标最低:证明SHIP++能有效降低光谱失真和空间失真,实现「高空间分辨率+高光谱保真度」的双重目标;
- 全分辨率场景(高分2号):QNR指标达0.8493,显著优于其他方法,验证了模型在真实高分辨率遥感场景的强泛化性。
5.2.2.2 (2)定性结果
SHIP++的全色锐化结果无光谱偏移、空间纹理清晰,与真实标签的MSE残差最小(残差图为浅蓝,代表误差低);而其他方法存在明显问题:
- 传统方法(GS/Brovey/IHS):光谱失真严重,存在颜色偏移;
- 深度学习方法(PNN/PANNet/SFINet):空间纹理模糊,MSE残差图为深黄/红,代表误差高。
5.3 SHIP++模块消融实验
在VIF的M3FD数据集和全色锐化的Worldview-II数据集上,对SHIP++的RIM、COII、COAE三大模块开展消融实验,验证各模块的有效性,核心结论:
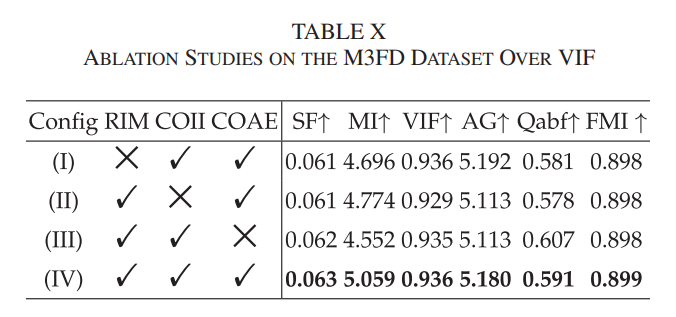
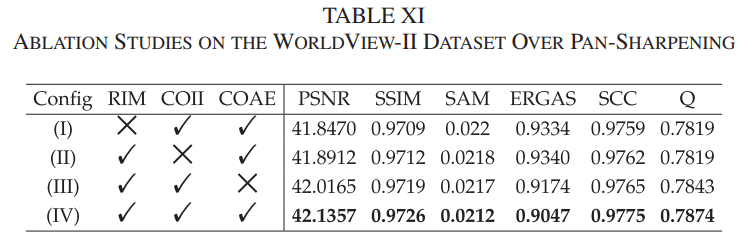
- 三大模块均为性能提升的关键:移除任一模块,模型性能均会显著下降,且三大模块的协同作用能实现性能的叠加提升;
- 残差信息记忆(RIM):移除后主模态关键信息丢失,融合图像细节模糊、亮度失衡;
- 跨阶信息整合(COII):移除后无法整合不同阶数的互补特征,特征表示能力下降,融合图像的信息丰富度降低;
- 跨阶注意力演化(COAE):移除后注意力图无知识共享,浅层无法引导深层,注意力图对关键特征的捕捉精度下降,显著目标/纹理细节丢失。
5.4 实验核心结论
- SHIP/SHIP++在VIF和全色锐化两大任务上均显著优于SOTA方法,证明了双维度高阶交互建模的有效性;
- 高阶交互能捕捉多样化的互补特征模式,提升融合特征的丰富度和表示能力;
- SHIP++的三大模块针对性解决了传统迭代的核心问题,是性能提升的关键,且模块间具有协同效应;
- 模型在跨数据集、全分辨率场景下均表现出强泛化性,具有实际应用价值。
06 个人声明
本文为作者对原论文的学习笔记与心得分享,受个人学识与理解所限,文中对论文内容的解读或有不够周全之处,一切以原论文正式表述为准。本文仅用于学术交流与传播,内容均由作者独立整理完成,不代表本公众号立场。如文中所涉文字、图片等内容存在版权争议,请及时与作者联系,作者将在第一时间核实并妥善处理。
07
整体思想为什么是这样?这样做有什么好处?怎么能实现好效果
SHIP++在SHIP基础上,针对主模态信息丢失、不同阶数特征互补、注意力图精准性不足三大问题,设计**残差信息记忆(RIM)、跨阶信息整合(COII)、跨阶注意力演化(COAE)**三大核心机制,进一步提升跨模态信息交互能力,所有机制均适配VIF和全色锐化两大任务。
4.4.1 残差信息记忆(Residual Information Memorizing, RIM)
设计背景:VIF中的可见光图像、全色锐化中的多光谱图像为主模态,包含任务所需的核心信息,但传统迭代过程中主模态特征易被覆盖,导致细节丢失。 核心思路:通过残差连接将主模态原始特征与迭代过程中的特征融合,在每次迭代中保留主模态关键信息。 数学公式:
其中,为第i-1次迭代、第j阶的主模态特征,为主模态原始特征,Conv为卷积层(用于特征融合与维度匹配)。
4.4.2 跨阶信息整合(Cross-Order Information Integration, COII)
设计背景:不同阶数的空间高阶交互能捕捉多样化的互补特征模式(Fig.5),单独使用某一阶特征会损失信息丰富度。 核心思路:将同一迭代中所有阶数的空间高阶特征进行拼接与卷积融合,整合多样化互补特征,生成更具信息量的融合特征。 数学公式:
其中,为第i次迭代中1~N阶的空间高阶特征,concat为通道维度拼接,Conv为卷积层(用于特征整合)。
4.4.3 跨阶注意力演化(Cross-Order Attention Evolving, COAE)
设计背景:传统注意力图各层独立学习,无知识共享,浅层注意力无法引导深层注意力,导致深层注意力对关键特征的捕捉精度不足。 核心思路:借鉴注意力演化机制,通过残差连接实现不同阶数/层注意力图的知识共享,让浅层注意力引导深层注意力的学习,提升注意力图的精准性。 数学公式:
其中,为第i次迭代、第j阶的注意力图,为第j-1阶的注意力图,为当前阶的查询特征,concat为通道拼接,Norm为层归一化。
核心效果:注意力图从浅层到深层逐步精准,能更清晰地突出多模态的关键特征(如VIF中的行人/车辆、全色锐化中的地物纹理)。
4.5 损失函数设计
针对VIF和全色锐化两大任务的核心需求,设计任务专属的损失函数,引导模型学习贴合任务特性的融合特征,避免通用损失函数的局限性。
4.5.1 全色锐化任务:L1损失
任务需求:提升融合图像的空间分辨率和光谱保真度,让融合图像尽可能接近真实高分辨率多光谱图像(GT)。 损失公式:
其中,为网络输出的融合图像,GT为真实高分辨率多光谱图像,为L1范数(像素级误差)。
4.5.2 红外与可见光融合(VIF)任务:强度损失+梯度损失
任务需求:同时保留红外图像的显著目标和可见光图像的精细纹理,融合图像符合人类视觉感知。 整体损失:,其中为权衡参数,平衡强度损失和梯度损失的权重。
(1)显著性感知的强度损失()
核心思路:基于红外/可见光图像的显著性图设计加权系数,让融合图像更贴合双模态的显著区域,突出红外目标的同时保留可见光的亮度特征。 损失公式:
其中,为可见光/红外图像的加权图,为逐元素乘法,为L1范数;加权图由显著性矩阵S计算:,,S由[72]的显著性算法生成。
(2)最大梯度纹理损失()
核心思路:图像梯度代表纹理细节,通过Sobel算子计算双模态的梯度图,让融合图像的梯度图聚合双模态的最大梯度信息,保留最丰富的纹理细节。 损失公式:
其中,为Sobel算子的梯度计算操作,为逐元素取最大值,HW为图像像素总数,为L1范数。
05 实验分析
论文在红外与可见光图像融合(VIF)和全色锐化(pan-sharpening)两大任务上开展了全面的实验验证,包括SOTA方法对比、超参数消融实验、模块消融实验,采用定量指标+定性可视化+下游任务验证的方式,全方位验证SHIP/SHIP++的性能,并深入分析各模块/超参数的作用机理。
5.1 红外与可见光图像融合(VIF)实验
5.1.1 实验设置
- 数据集:
- 训练集:M3FD(4200对配对图像,3900对训练,300对官方测试);
- 跨数据集测试集:RoadScene、TNO(各随机选取25对,验证模型泛化性);
- 评价指标(所有指标值越高,融合效果越好): 空间频率(SF)、互信息(MI)、视觉信息保真度(VIF)、平均梯度(AG)、(边缘保持)、特征互信息(FMI)、SCD(显著目标保持);
- 实现细节: PyTorch框架、NVIDIA GTX 3090 GPU、Adam优化器()、30K迭代、批次大小8、初始学习率(每5K迭代衰减0.5)、特征补丁大小128×128。
5.1.2 SOTA对比分析
将SHIP/SHIP++与11种SOTA方法对比:DDcGAN、DenseFuse、AUIF、DIDFuse、ReCoNet、SDNet、TarDAL、U2Fusion、UMFusion、LRRNet、TIM,从定量指标、定性可视化、下游任务三方面验证性能优势。
(1)定量结果
SHIP++在M3FD、RoadScene、TNO三个数据集的所有7项评价指标上均取得最优结果,核心优势体现在:
- MI/FMI指标显著高于其他方法:说明SHIP++能更充分地整合红外/可见光的互补信息,融合图像包含更丰富的多模态特征;
- SF/AG/指标最优:证明SHIP++能更好地保留可见光的精细纹理和边缘特征,融合图像的空间细节更丰富;
- VIF指标最高:表明融合图像的视觉质量更优、失真更小,更符合人类视觉感知;
- SCD指标最低(最优):说明SHIP++能更精准地保留红外图像的显著目标(如车辆、行人)。
(2)定性结果
SHIP++的融合图像实现了「红外显著目标+可见光精细纹理」的完美平衡,核心优势:
- 显著目标突出:红外图像中的车辆、行人对比度高、轮廓清晰;
- 纹理细节丰富:可见光图像中的树叶、建筑、路面纹理保留完整;
- 视觉效果自然:无亮度失衡、模糊、伪影等问题。
对比其他方法的不足:
- DenseFuse/SDNet/U2Fusion:无法有效突出红外显著目标,融合图像对比度低;
- DDcGAN/ReCoNet:可见光纹理捕捉不足,融合图像模糊,存在伪影;
- DIDFuse:能捕捉红外热特征,但亮度偏低,视觉效果差。
(3)下游任务验证(目标检测)
以FCOS为目标检测模型,在M3FD融合结果上进行目标检测(检测类别:灯、汽车、公交车、摩托车、卡车、行人),SHIP++的mAP指标达0.488,显著高于所有SOTA方法,证明其融合图像能为下游计算机视觉任务提供更有效的特征信息,具有实际应用价值。
5.1.3 消融实验
在M3FD数据集上开展消融实验,探究阶数N、迭代数L、空间-通道维度对模型性能的影响,确定最优超参数,并验证双维度交互的必要性。
(1)阶数N与迭代数L的消融
- 阶数N:模型性能随N增加逐步提升,N=5时性能趋于稳定(继续增加N无明显提升,且增加计算成本);不同N的特征可视化显示,阶数越高,显著目标的特征响应越强。
- 迭代数L:性能随L增加先提升后下降,L=3为最优;L过大时,梯度传播困难,导致SF/AG等纹理指标下降;不同L的定性结果显示,L越多,显著目标的轮廓越精准。
【插入Fig.12 迭代数L消融的定性结果图】 【插入Fig.14 迭代数L消融的定量曲线图】
(2)空间-通道维度的消融
验证空间/通道高阶交互的必要性和执行顺序的鲁棒性,设置4种配置:①空间-通道(默认);②通道-空间;③无空间;④无通道,核心结论:
- 双维度交互缺一不可:移除空间/通道任一维度,模型性能显著下降(SF/MI/VIF等指标大幅降低),定性结果显示融合图像亮度失衡、细节丢失;
- 执行顺序鲁棒:空间-通道/通道-空间的执行顺序对性能影响极小,验证了SHIP高阶交互机制的鲁棒性。
5.2 全色锐化(pan-sharpening)实验
5.2.1 实验设置
- 数据集:Worldview-II、Worldview-III、高分2号(Gaofen2),包含全分辨率测试集(验证模型在真实高分辨率场景的泛化性);
- 评价指标:
- 越高越好:PSNR(峰值信噪比)、SSIM(结构相似性)、SCC(相关系数)、QNR(综合质量);
- 越低越好:SAM(光谱角映射)、ERGAS(相对无维全局误差)、(光谱失真)、(空间失真);
- 实现细节: Adam优化器、1000轮训练、批次大小4、初始学习率(200轮后衰减0.5);因无真实标签,采用Wald协议构建训练数据集(将高分辨率MS图像下采样为LRMS,作为模型输入);PAN补丁大小128×128,MS补丁大小32×32。
5.2.2 SOTA对比分析
将SHIP/SHIP++与传统方法(SFIM、GS、Brovey、IHS、GFPCA)和深度学习SOTA方法(PNN、PANNet、MSDCNN、SRPPNN、GPPNN、INNformer、MutNet、SFINet、GSFL、CANL)对比,核心结论:
(1)定量结果
SHIP++在三个卫星数据集的所有评价指标上均实现最优,核心优势:
- PSNR/SSIM/SCC/QNR指标最高:说明SHIP++的融合图像空间分辨率高、结构相似性好,与真实标签的贴合度最高;
- SAM/ERGAS//指标最低:证明SHIP++能有效降低光谱失真和空间失真,实现「高空间分辨率+高光谱保真度」的双重目标;
- 全分辨率场景(高分2号):QNR指标达0.8493,显著优于其他方法,验证了模型在真实高分辨率遥感场景的强泛化性。
(2)定性结果
SHIP++的全色锐化结果无光谱偏移、空间纹理清晰,与真实标签的MSE残差最小(残差图为浅蓝,代表误差低);而其他方法存在明显问题:
- 传统方法(GS/Brovey/IHS):光谱失真严重,存在颜色偏移;
- 深度学习方法(PNN/PANNet/SFINet):空间纹理模糊,MSE残差图为深黄/红,代表误差高。
5.3 SHIP++模块消融实验
在VIF的M3FD数据集和全色锐化的Worldview-II数据集上,对SHIP++的RIM、COII、COAE三大模块开展消融实验,验证各模块的有效性,核心结论:
- 三大模块均为性能提升的关键:移除任一模块,模型性能均会显著下降,且三大模块的协同作用能实现性能的叠加提升;
- 残差信息记忆(RIM):移除后主模态关键信息丢失,融合图像细节模糊、亮度失衡;
- 跨阶信息整合(COII):移除后无法整合不同阶数的互补特征,特征表示能力下降,融合图像的信息丰富度降低;
- 跨阶注意力演化(COAE):移除后注意力图无知识共享,浅层无法引导深层,注意力图对关键特征的捕捉精度下降,显著目标/纹理细节丢失。
5.4 实验核心结论
- SHIP/SHIP++在VIF和全色锐化两大任务上均显著优于SOTA方法,证明了双维度高阶交互建模的有效性;
- 高阶交互能捕捉多样化的互补特征模式,提升融合特征的丰富度和表示能力;
- SHIP++的三大模块针对性解决了传统迭代的核心问题,是性能提升的关键,且模块间具有协同效应;
- 模型在跨数据集、全分辨率场景下均表现出强泛化性,具有实际应用价值。
06 个人声明
本文为作者对原论文的学习笔记与心得分享,受个人学识与理解所限,文中对论文内容的解读或有不够周全之处,一切以原论文正式表述为准。本文仅用于学术交流与传播,内容均由作者独立整理完成,不代表本公众号立场。如文中所涉文字、图片等内容存在版权争议,请及时与作者联系,作者将在第一时间核实并妥善处理。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或赞助支持!
音乐
暂未播放