


论文阅读 TIV 2024 CDC-YOLOFusion 利用跨尺度动态卷积融合实现可见光-红外目标检测
TIV 2024 | CDC-YOLOFusion:利用跨尺度动态卷积融合实现可见光-红外目标检测
01 论文信息
- 论文题目: CDC-YOLOFusion: Leveraging Cross-scale Dynamic Convolution Fusion for Visible-Infrared Object Detection
- 论文作者: Jinfu Liu,Qing Guo,Hongyu Zhang,等
- 发表单位: Jinfu Liu,Qing Guo,Hongyu Zhang ,湖南大学,华中科技大学等
- 发表会议\期刊: IEEE Transactions on Intelligent Vehicles(TIV),2024
- 论文链接: https://ieeexplore.ieee.org/document/10636773
- 代码链接: https://github.com/Morph-3800/CDC%20YOLOFusion
02 论文主要贡献
本文围绕可见光-红外目标检测中特征融合适应性不足的问题展开,核心目标是让融合网络能够根据输入样本的跨模态差异动态调整特征提取方式,而不是依赖固定卷积堆叠进行简单融合。
从摘要和引言来看,论文的主要贡献可以概括为:一方面,它把跨模态局部信息交换引入训练过程,使模型更容易学习可见光与红外图像在局部区域中的相关性;另一方面,它把动态卷积用于多尺度双模态特征融合,使融合特征同时保留共同显著信息与模态差异信息。实验部分进一步说明,该思路能够嵌入多种检测流水线,并在 VEDAI、FLIR、LLVIP 等数据集上带来稳定性能提升。
03 论文创新点
- 提出用于可见光-红外目标检测的“跨尺度动态卷积驱动 YOLO 融合(CDC-YOLOFusion)”网络,并引入跨模态数据交换(CDS)技术进行有效的双模态数据交换,生成能够捕捉局部区域跨模态相关性的增强数据。
- 设计跨尺度动态卷积融合(CDCF)模块,利用跨尺度特征分别增强各模态动态卷积核预测;所提出的差异注意力掩码用于探索模态间独特性并促进互补特征提取,从而获得更优的特征提取卷积核。
- 设计跨模态核交互损失(Cross-modal Kernel Interaction Loss),有效引导 CDCF 的核学习过程,使卷积核同时关注两种模态的共同显著特征与各自独特特征,以提取用于目标检测的显著双模态特征。
04 方法
4.1 架构概述
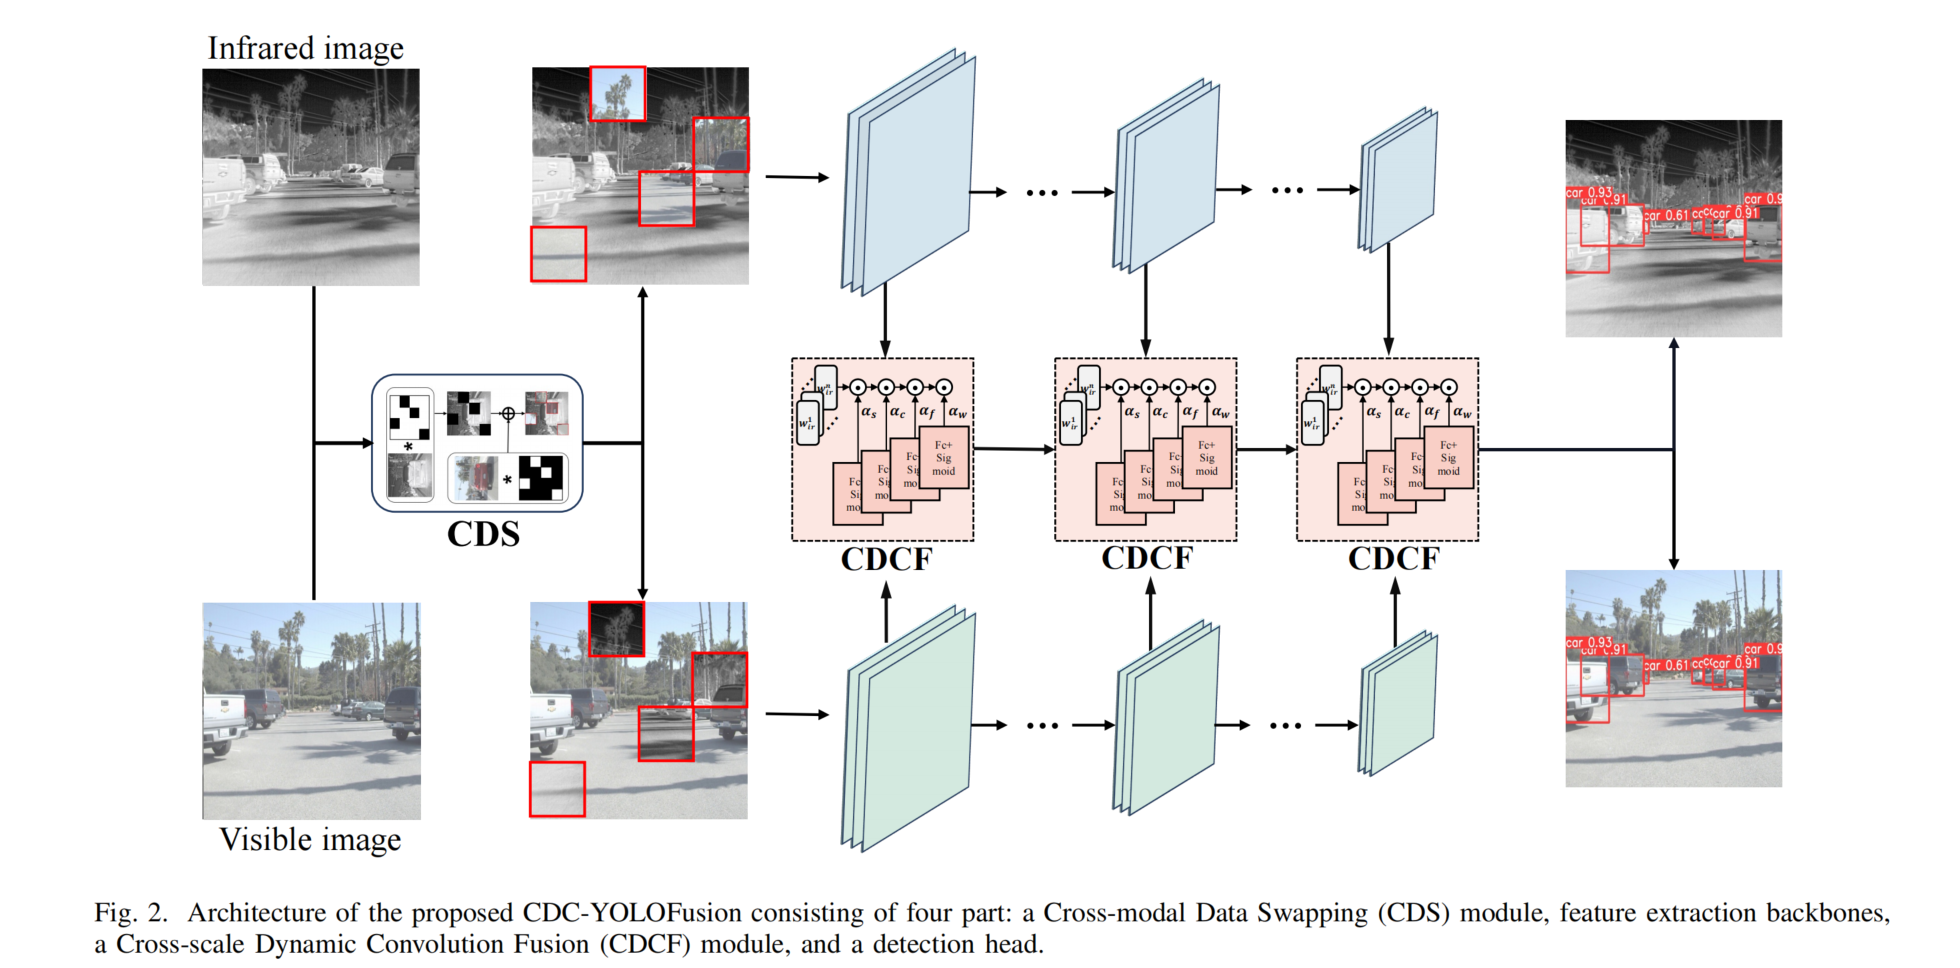
图2. 所提出的CDC-YOLOFusion的架构,由四个部分组成:跨模态数据交换(CDS)模块、特征提取骨干网络、跨尺度动态卷积融合(CDCF)模块和检测头。 传统数据增强技术多关注单模态数据,而CDS旨在提高模型对模态差异的理解,促进跨模态相关性学习。其通过将红外图像中的局部块替换为可见光图像中的对应块,生成含混合信息的图像输入特征提取分支。
图 2 展示了我们提出的 CDC-YOLOFusion 的流程图,它扩展了 YOLO v5 架构,采用双分支 CSPDarknet 骨干网络分别提取多尺度的可见光和红外特征。值得注意的是,我们引入了两个新颖的组件来提高检测性能:首先,我们引入了跨模态数据交换(CDS)模块用于预处理输入图像。CDS 促进有效的双模态数据交换和信息互补,产生混合的双模态数据,鼓励模型更好地探索跨模态特征。其次,我们引入了跨尺度动态卷积融合(CDCF)模块来促进多尺度双模态特征融合。与传统的卷积操作不同,CDCF 采用从输入数据中自适应学习的动态卷积核来捕捉更有价值的信息。此外,我们设计了一种新颖的 “跨模态核交互” 损失,通过利用双模态核的固有特征分布来引导双模态核的学习,从而生成用于稳健特征提取的信息核。
4.2 跨模态数据交换(CDS)
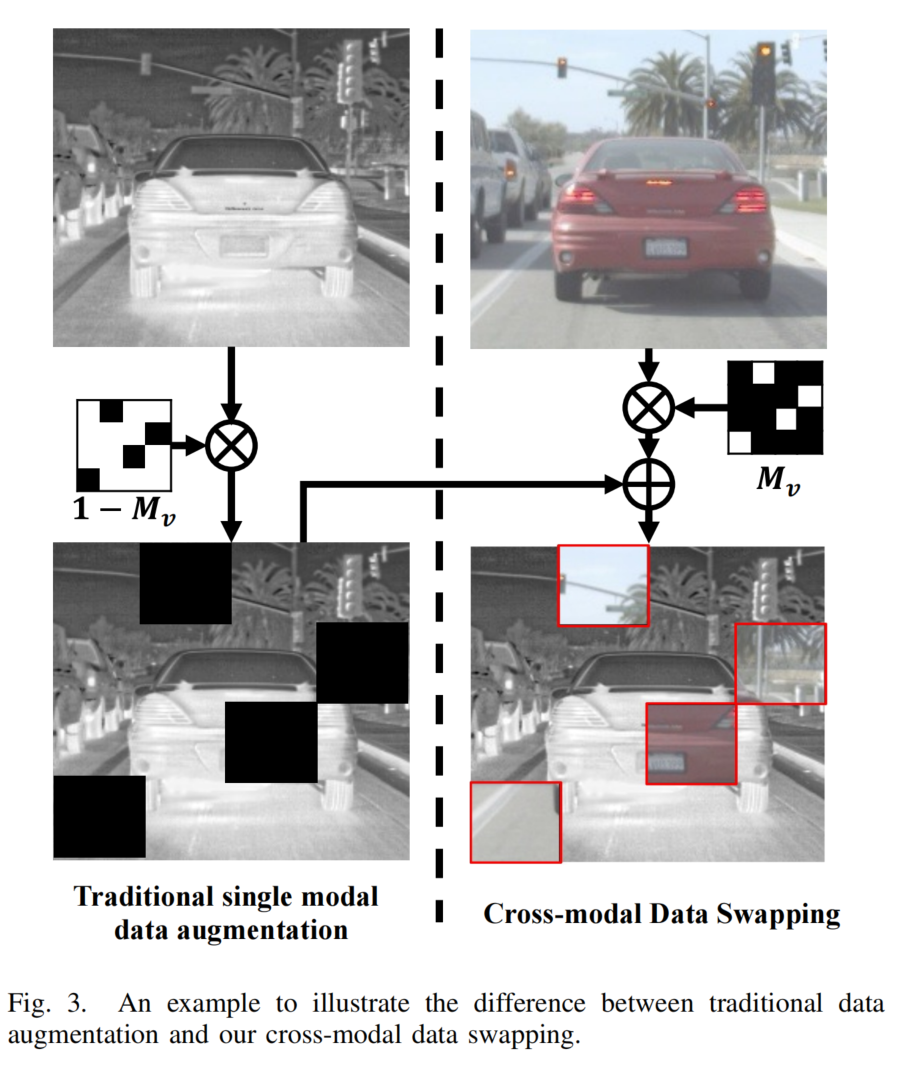
图3. 一个示例,用于说明传统数据增强与我们的跨模态数据交换之间的差异。
传统的数据增强技术,如裁剪(如图 3 所示),广泛应用于目标检测任务,有助于丰富训练数据集并增强模型的泛化能力。然而,现有的增强方法主要关注单模态数据,忽略了对跨模态增强技术的探索。相反,深入研究跨模态增强策略有望有效揭示不同模态之间的相关性,从而为特征提取网络提取稳健特征提供更好的指导。出于这一目的,我们引入了跨模态数据交换(CDS),旨在提高模型对模态差异的理解,并促进跨模态相关性的学习。图 3 展示了一个示例来说明 CDS 的效果,其中红外图像中的一个局部块被可见光图像中的对应块替换,从而生成一个混合信息的红外图像,随后将其输入到相应的特征提取分支以探索跨模态特征提取。
具体来说,给定一对高度为 H、宽度为 W 的可见光 - 红外图像、,我们首先为它们分别构建两个交换掩码、,其中两个掩码中的每个初始元素都设置为 0。接下来,我们将每个掩码划分为个局部区域,并随机选择 N 个区域作为交换候选,将交换候选中的元素重置为 1。因此,它生成两个交换掩码来指导跨模态数据交换,实现方式如下(见图 3):
其中、,表示元素级乘法,表示通过 CDS 生成的图像。CDS 执行跨模态部分数据交换,生成同时包含两种模态信息的混合图像。因此,与通过破坏单模态数据进行的传统裁剪和马赛克数据增强操作相比,CDS 提供了更丰富的训练数据,同时有效保留了多模态图像的统一高级语义。它能够巧妙地捕捉局部区域内的跨模态相关性,促进更丰富的跨模态互补细节的吸收。这反过来又增强了网络在训练过程中的鲁棒性。
4.3 跨尺度动态卷积融合(CDCF)
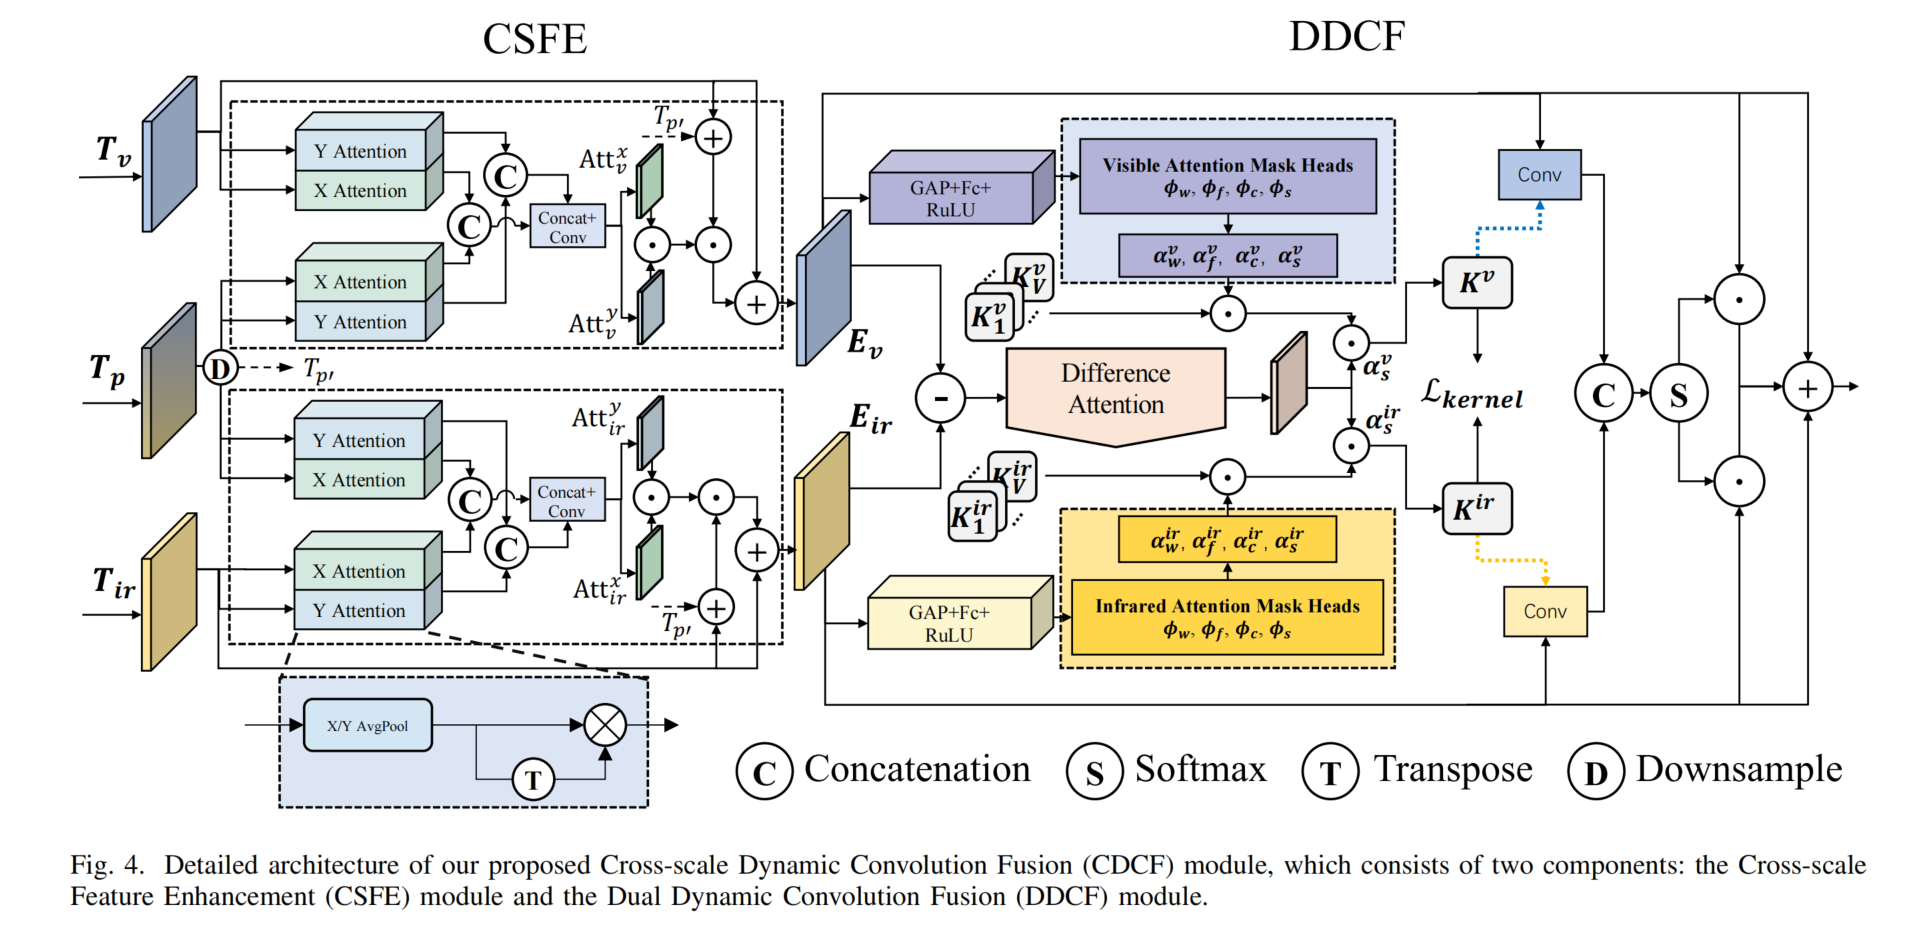
图4. 我们提出的跨尺度动态卷积融合(CDCF)模块的详细架构,该模块由两个组件组成:跨尺度特征增强(CSFE)模块和双动态卷积融合(DDCF)模块。
我们引入了跨尺度动态卷积融合(CDCF)模块,该模块通过利用每种模态数据的固有特征,独立学习适用于该模态数据的自适应核。图 4 展示了我们提出的 CDCF 模块的架构,它包括两个主要组件:跨尺度特征增强(CSFE)模块和双动态卷积融合(DDCF)模块。
4.4 跨尺度特征增强模块(CSFE)
我们的方法没有直接拼接双模态特征,而是引入了跨尺度特征增强(CSFE)模块来生成增强的可见光和红外特征,用于预测动态卷积核。如图 4 所示,当给定第 l 层的一对可见光和红外特征、,以及 CDCF 生成的第 层的融合特征时,CSFE 首先使用 3×3 卷积核对进行下采样,以获得调整大小的融合特征。由于带来了更大尺度特征图提供的更丰富的特征,有助于通过跨尺度特征融合来指导当前层特征的增强。然后,我们分别对、和采用 X 注意力和 Y 注意力机制。理论上,X/Y 注意力旨在探索高度 / 宽度与通道之间的复杂相关性,包括沿高度 / 宽度方向计算特征平均值,公式如下:
其中,,,表示位置处的特征向量。因此,我们的方法为 X 注意力生成三个注意力特征图、、,为 Y 注意力生成、、。与常用的自注意力机制相比,CSFE 中使用的跨尺度 X/Y 注意力能够更有效地探索相对位置信息和通道注意力信息之间的复杂相关性,同时仅略微增加计算和参数开销,在高度和宽度方向上产生显著的特征图,作为预测动态卷积核的指导。
接下来,对于 X 注意力和 Y 注意力特征和,我们计算其 Gram 矩阵和,以获得特征图内的高度 / 宽度相关信息,然后将它们分别与和相乘,丰富通道与高度 / 宽度之间的关系捕捉,公式如下:
其中,和分别表示 X 和 Y 方向上的相关性增强注意力图。之后,我们利用跨尺度融合信息来增强每种模态,表示为:
其中,和是两个卷积层,[] 表示拼接操作。和分别是 X 和 Y 方向上的跨尺度增强单模态特征图。为了使和能够在两个方向上拼接以进行信息交互,我们将重塑为。然后,我们将它们拼接以实现信息交互,获得激活的注意力图,表示宽度、高度和通道中的显著特征图:
其中是由卷积层、批归一化层和激活函数组成的函数。和表示交互后宽度、高度和通道中的新显著特征图。然后我们将重塑为。最后,这两个注意力图作用于输入特征以获得增强特征,表示为:
4.5 双动态卷积融合模块(DDCF)
给定一个高度为 H、宽度为 W、通道数为的输入特征,以及 V 个卷积核,现有的动态卷积方法 [40] 从 X 中构建四个特征注意力掩码,包括空间注意力掩码、输入通道注意力掩码、输出通道注意力掩码和核注意力掩码,公式如下:
其中,表示由全局平均池化层(GAP)、全连接层(FC)、ReLU 激活函数和头部分支组成的序列操作。然后,将这些掩码应用于 V 个卷积核,得到聚合的动态卷积核 K,计算如下:
其中表示中的第 v 个元素。得到的动态卷积核可以通过探索各种注意力维度动态适应特征 X,从而帮助模型提取增强的目标检测特征。在此基础上,我们的方法进一步深入研究可见光和红外特征之间的差异,并引入特征差异注意力掩码。这一添加使我们的卷积核能够更好地探索模态间的独特性,并促进互补特征的提取。具体来说,给定一对输入的可见光和红外特征,我们的方法首先采用模态差异提取网络生成差异注意力掩码,表示为:
其中、,表示 函数,是由多层感知机(MLP)和全局最大池化层组成的网络,是由 MLP 和全局平均池化层组成的网络,MLP 是由 1×1 卷积、ReLU 激活函数和另一个 1×1 卷积组成的独特感知机网络。因此,通过将掩码纳入公式(8),我们得到依赖于模态的动态卷积核如下:
其中、、、分别表示模态 m 上的核注意力掩码、输出通道注意力掩码、输入通道注意力掩码和空间注意力掩码中的第 v 个元素。具体来说,我们的方法将公式(6)中的输入到公式(7)中以计算这些参数,包括空间注意力掩码、输入通道注意力掩码、输出通道注意力掩码、核注意力掩码和差异注意力掩码,上述注意力掩码沿第一维度分为 V 个子掩码,即、、、和。将来自五种注意力掩码的 V 个子掩码与 V 个卷积核聚合后,我们得到如公式(10)所示的动态卷积核。接下来,我们将依赖于模态的动态卷积核与相应的模态特征相乘,得到增强特征:
其中 * 表示卷积操作。最后,我们对两个卷积结果和进行互补融合,它们包含模态属性和模态间可变性,确保融合结果包含模态共性和独特可变性。具体公式如下:
与从拼接的多模态特征生成动态卷积核相比,我们的方法采用增强的单模态特征作为生成动态卷积核和的原始数据。这种方法最大限度地保留了不同模态输入数据中的独特特征,使核能够专注于特定于模态的特征。此外,差异特征注意力的引入使卷积核对模态间差异更加敏感,使它们能够选择性地提取差异特征以进行互补融合。
4.6 跨模态核交互损失( )
为了通过 CDCF 有效引导动态卷积核的生成,我们的方法采用监督学习,并引入了一种新颖的损失函数 “核交互损失( )”。给定从不同模态中学习到的两个待学习核和,我们的方法旨在开发能够捕捉两种模态的共同显著特征,同时识别每种模态中独特显著特征的核函数。这使得能够准确识别双模态数据中的互补特征。基于这一思想,我们的方法利用 Jensen-Shannon(JS)散度来衡量分布之间的差异。JS 散度评估两个分布之间的相似性,当它们相似时接近零,不相似时达到 1。通过利用这一散度度量,我们的方法计算和之间的 JS 值,旨在最小化分布差异,以便两个核都能有效捕捉两种模态的共同特征,表示为:
同时,我们的方法旨在让和分别捕捉可见光和红外数据中的独特特征。我们使用两个核之间的差异来表示这种独特特征捕捉,记为和,分别对应可见光和红外数据中的独特特征检测。这种关系表示为:
其中是符号函数,将所有负值设为零。因此,我们的方法期望和表现出具有高 JS 值的不同分布,有效捕捉两种模态的独特特征。最终,我们的核交互损失公式如下:
其中是平衡权重。要求学习到的动态卷积核捕捉共同的显著特征,同时关注每种模态的独特特征。这种双重关注有助于提取更全面的特征,从而提高模型的目标检测性能。
实现:所提出的跨尺度动态卷积融合模块在各种特征尺度上运行,生成多尺度融合特征,这些特征被输入到预测头以产生最终的检测结果。在训练过程中,我们使用由两个主要组件组成的复合损失函数:目标检测损失(包括边界框回归、目标分类和目标置信度)和 CDCFM 中的 KI 损失。最终的损失函数公式如下:
其中是平衡权重。
05 实验分析
5.1 数据集
我们在 VEDAI 、FLIR 和 LLVIP 上进行实验,以评估我们的 CDC-YOLOFusion。
- VEDAI:该航空数据集主要用于车辆检测,存在小目标尺寸、多方向性、光照和阴影变化、镜面反射及遮挡等挑战。提供九类严格对齐的可见光和红外图像对,含1250对两种分辨率(1024×1024和512×512)的图像对。我们使用更高分辨率,其中1089对用于训练,161对用于测试。
- FLIR:为多光谱目标检测带来挑战,涵盖白天和黑夜条件下的三类(“人”“车”“自行车”)。原始数据集图像对未对齐,本研究使用[51]中的对齐版本,含5142对可见光-红外图像对,其中4129对用于训练,1013对用于测试。
- LLVIP:该大规模行人数据集在低光环境下拍摄,多数图像处于极暗环境。所有可见光-红外图像对在空间和时间上严格对齐,含15488对图像,12025对用于训练,其余3463对用于测试。
5.2 设置
我们的方法基于CSPDarknet53在YOLOv5架构上构建双分支特征提取骨干网络,分别提取多尺度的可见光和红外特征。在CDCF模块中,跨模态核交互损失中参数。第一个CDCF层仅使用DDCF模块融合骨干网络特征;从第二层开始,CDCF在通过DDCF融合前使用CSFE增强特征。
训练在NVIDIA GeForce RTX A6000上进行,采用SGD优化器,批处理大小设为8,公式(16)中权重,初始学习率0.001,权重衰减0.0005,动量0.937。共训练500个epoch以确保模型良好收敛。
5.3 实验结果
消融实验:检验CDS和CDCF模块的实用性,设计四种实验设置(见表1)。
- 第一种:排除CDS和CDCF,用“加法”融合原始对齐图像对训练骨干网络。
- 第二种:在CDC-YOLOFusion框架内,用元素级加法替代CDCF进行特征融合。
- 第三种:使用CDCF模块,但CDS数据交换概率为0。
- 第四种:同时使用CDS和CDCF。
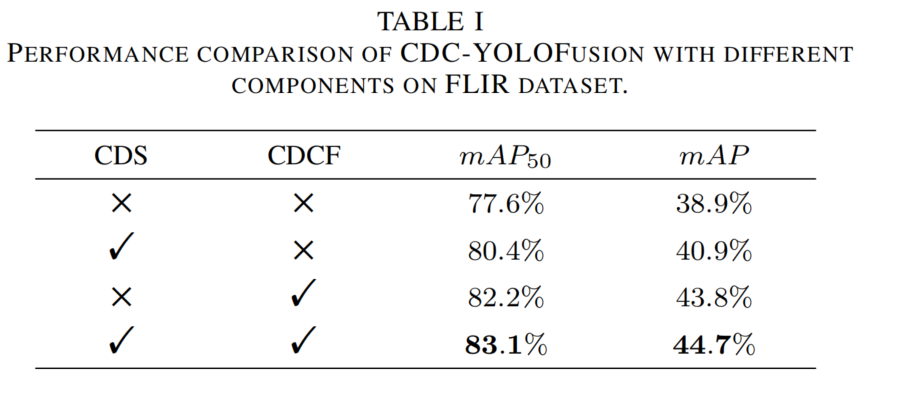
表1 CDC-YOLOFusion在FLIR数据集上不同组件的性能比较
结果表明:
- CDS能提升性能,mAP从38.9%升至40.9%,其局部区域交换策略帮助骨干网络学习跨模态相关性。
- 单独使用CDCF可显著提升mAP(+4.9%),归因于多尺度特征聚合和动态卷积机制,在指导下生成的卷积核专注于模态独特特征和共同特征。
- 两者结合性能最佳(mAP=44.7%),证明CDC-YOLOFusion有效性。
CDS的评估:评估CDS的图像处理策略及区域划分中的影响(见表2)。
- 当时,CDS性能最佳(mAP=44.7%),同下比裁剪策略mAP高约0.5%,说明CDS增强了模型对模态差异的理解。
- 时交换区域过小,难以提供足够跨模态知识;时区域过大,导致原始数据信息丢失过多。
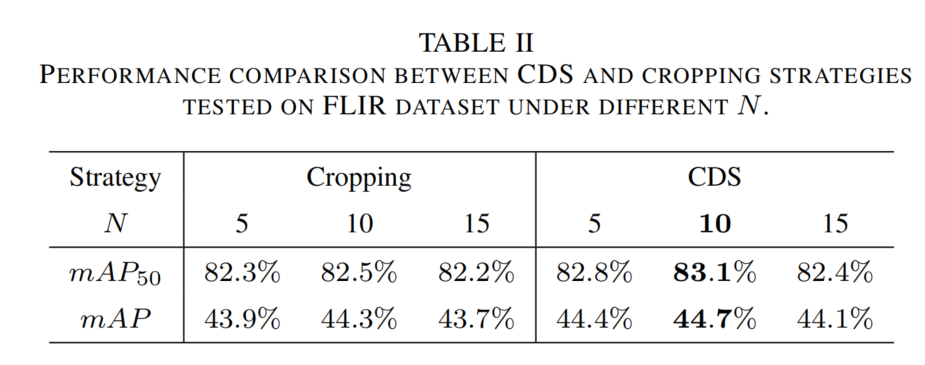
表2 FLIR数据集上CDS和裁剪策略在不同下的性能比较
此外,评估CDS数据增强概率(见表3),概率为0.3时性能最佳。概率过高会破坏单模态信息,过低则无法提供足够跨模态知识。
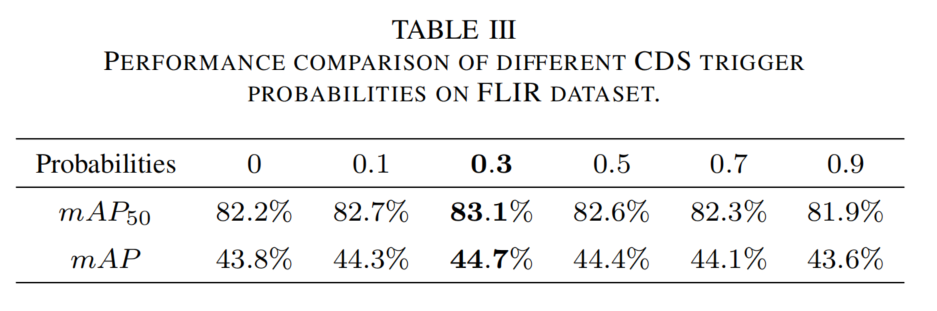
表3 FLIR数据集上不同CDS触发概率(每个区域以概率 被交换)的性能比较
CDCF的评估:评估CDCF中CSFE和DDCF的作用(见表4)。
- 不使用DDCF时,用元素级加法替代融合。
- 使用DDCF时,对比是否采用差异特征注意力。
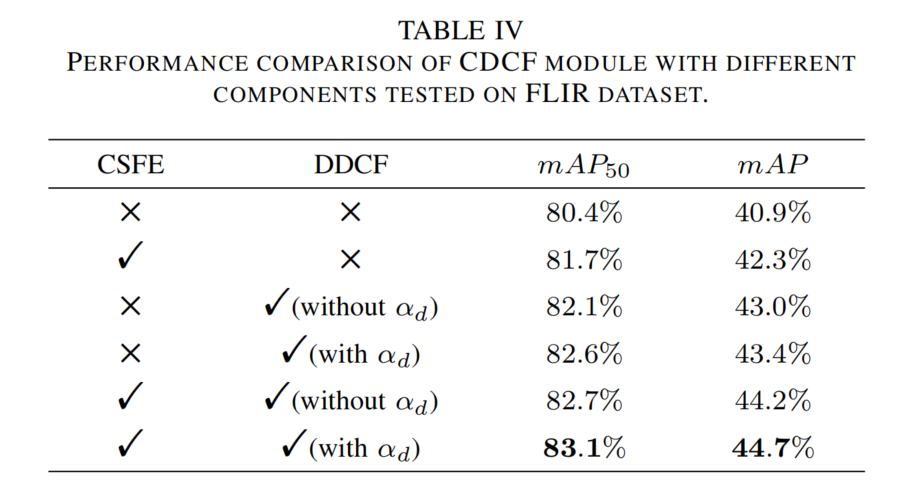
表4 FLIR数据集上CDCF模块不同组件的性能比较
结果显示:
- 单独使用CSFE,mAP提升1.4%,其跨尺度特征增强为动态卷积核生成提供丰富多尺度特征。
- 单独使用DDCF,mAP提升约2.5%,利用模态信息生成动态卷积核可关注跨模态特征;引入可进一步提升mAP约0.5%,增强捕捉模态间差异特征的能力。
图5展示CDCF模块效果,深红色表示显著特征,蓝色为背景特征。骨干网络初始特征和差异明显,CDCF生成的动态卷积核细化特征后,和特征分布相似,目标区域增强,噪声被抑制,融合特征指导准确检测。
CSFE中注意力机制评估:比较X/Y注意力与自注意力(见表5)。X/Y注意力以更少参数(153.6 M vs 204.2 M)和更快测试速度(65.1 ms vs 109.2 ms)实现更高精度,因其能以较低成本提供相对位置和通道信息。
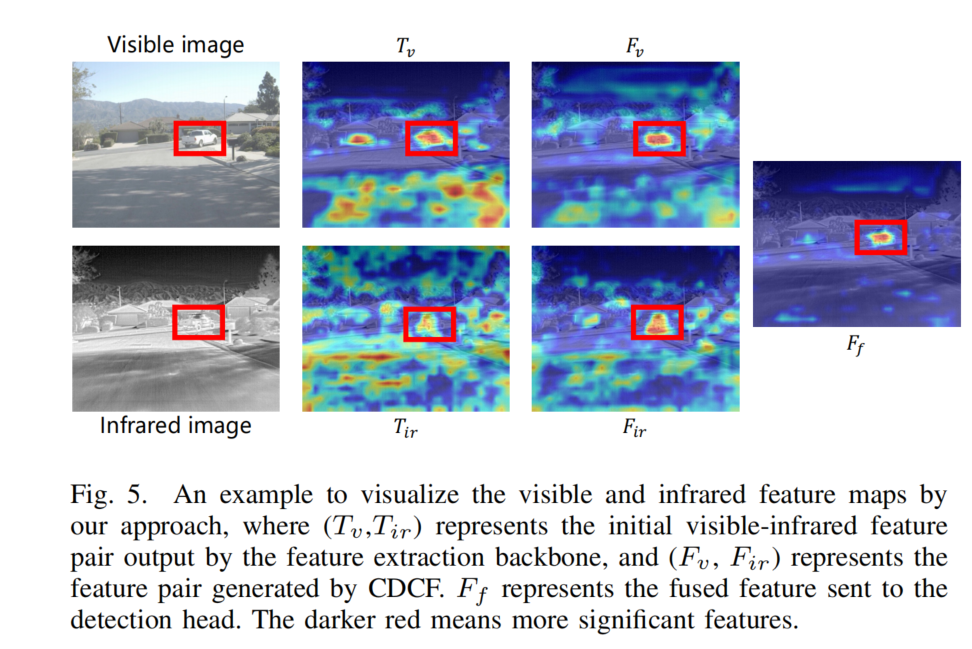
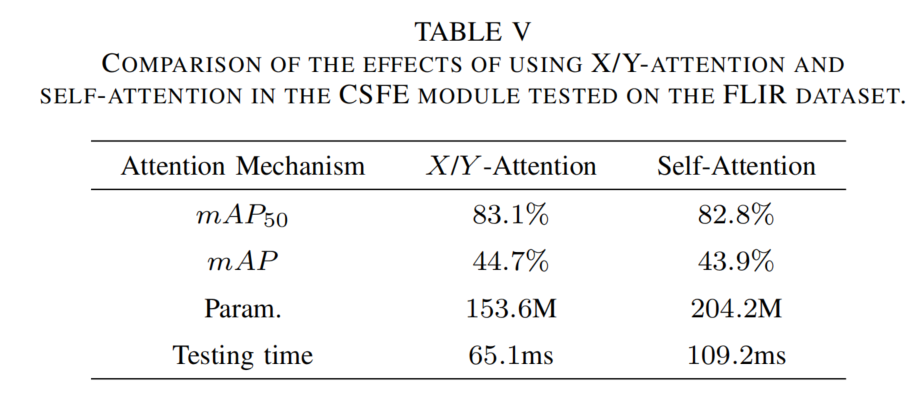
表5 FLIR数据集上CSFE模块中X/Y注意力与自注意力的效果比较
DDCF中卷积核数量评估:评估聚合卷积核数量的影响(见表6)。时性能最佳,时特征表示能力受限,时精度稳定但参数增加。
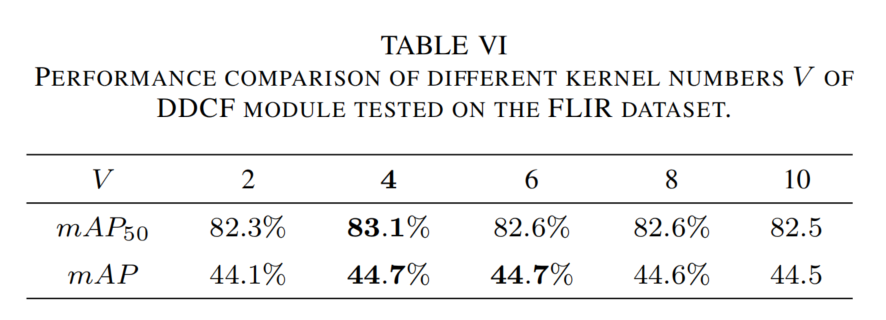
表6 FLIR数据集上DDCF模块不同核数量的性能比较
CDCF模块通用性评估:将CDCF集成到三种骨干网络(见表7),与基线融合方法(元素级加法)相比,在CFT、LRAF-Net和YOLO v5上分别获得2.9%、1.3%和4.9%的绝对增益,证明其在CNN和Transformer-based骨干网络上的稳健性。
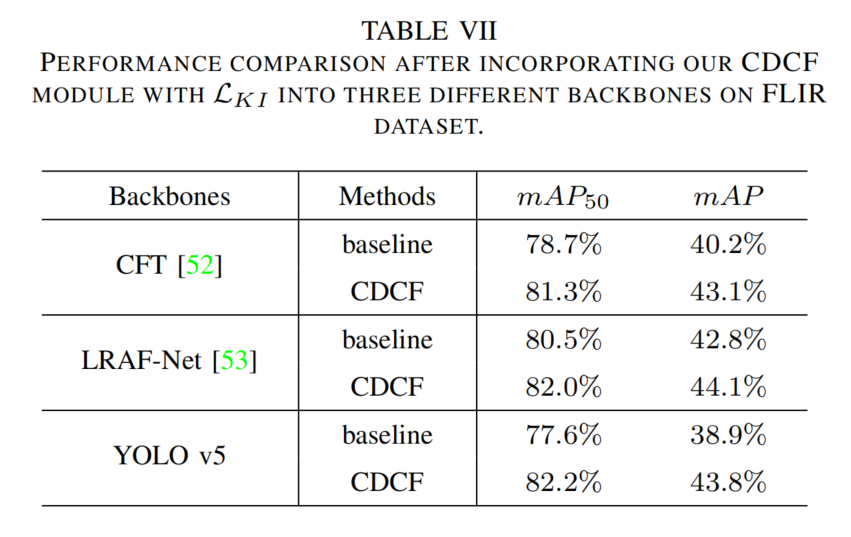
表7 FLIR数据集上CDCF模块集成到不同骨干网络的性能比较
KI损失的评估:评估公式(15)中权重的影响(见表8),时性能最佳(mAP=44.7%)。过小,动态卷积核忽略共同特征;过大,忽略独特特征,均导致性能下降。
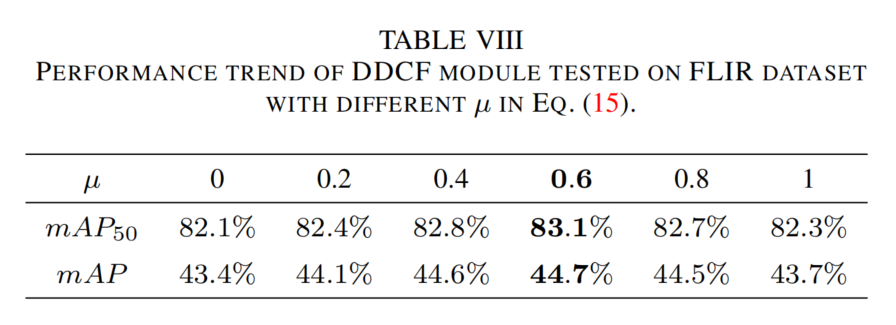
表8 公式(15)中不同值下DDCF模块在FLIR数据集上的性能趋势
评估公式(16)中权重的影响(见表9),时性能最佳(mAP=44.7%)。过小,引导卷积核能力弱;过大,掩盖目标检测损失,均导致性能下降。
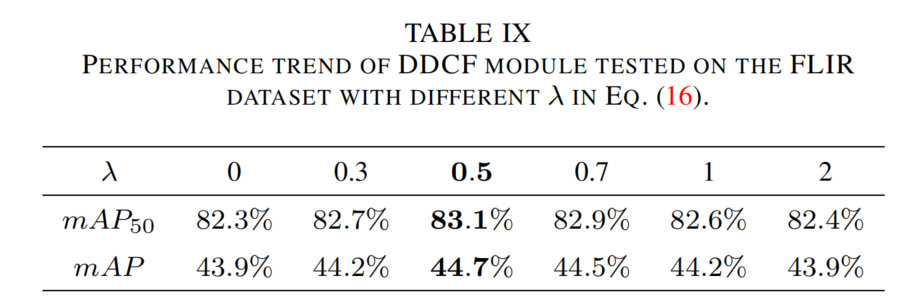
表9 公式(16)中不同值下DDCF模块在FLIR数据集上的性能趋势
5.4 与最先进方法的比较
将CDC-YOLOFusion与单模态和多模态检测器在三个数据集上比较(表10-12)。
- 单模态中,红外检测器通常优于可见光检测器,因夜间可见光失效而红外可提供目标特征。
- 多模态方法因融合两种特征性能更优,CDC-YOLOFusion表现最佳,mAP提升约2%-3%,原因在于:CDS提供跨模态特征;CDCF生成含模态特定和共同特征的动态卷积核;KI损失约束提取共同和独特特征。
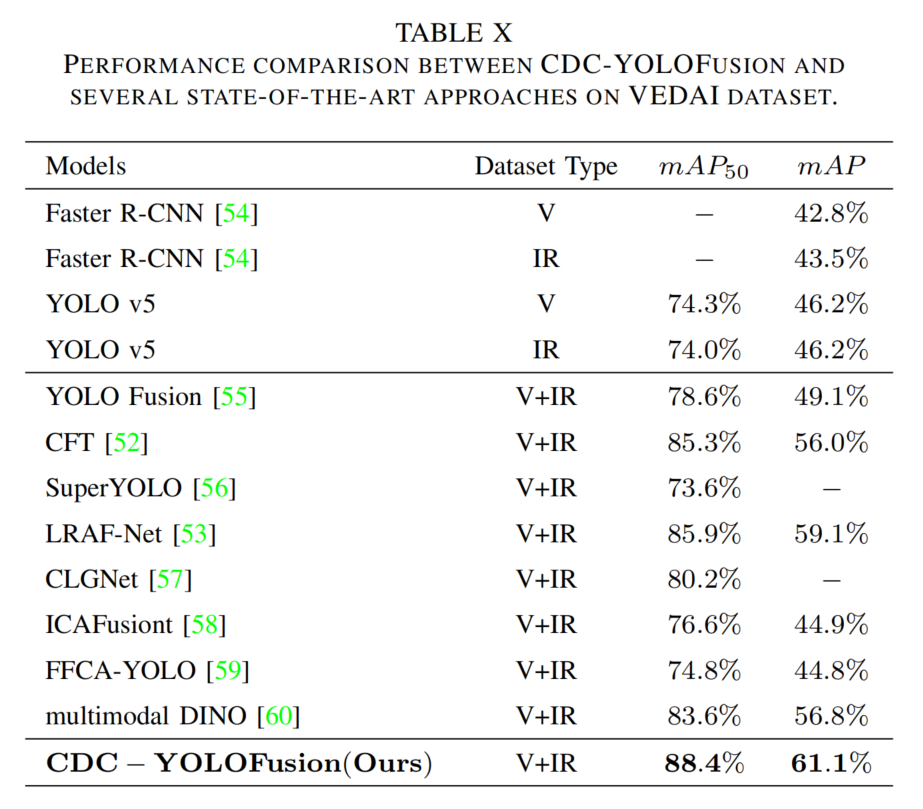
表10 VEDAI数据集上的性能比较
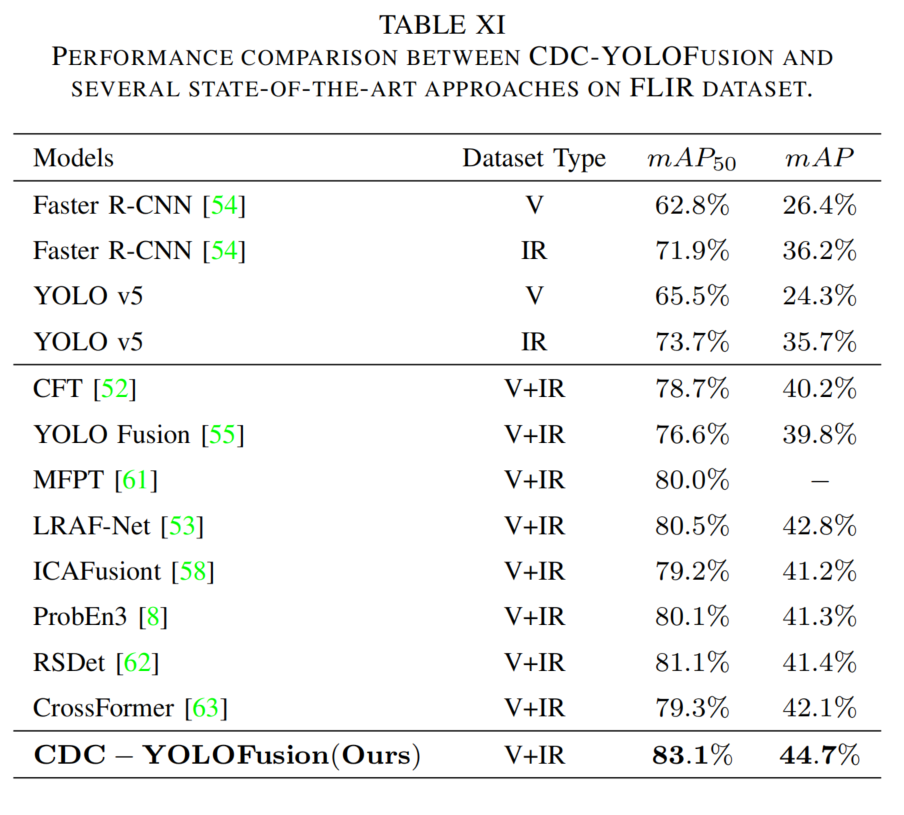
表11 FLIR数据集上的性能比较
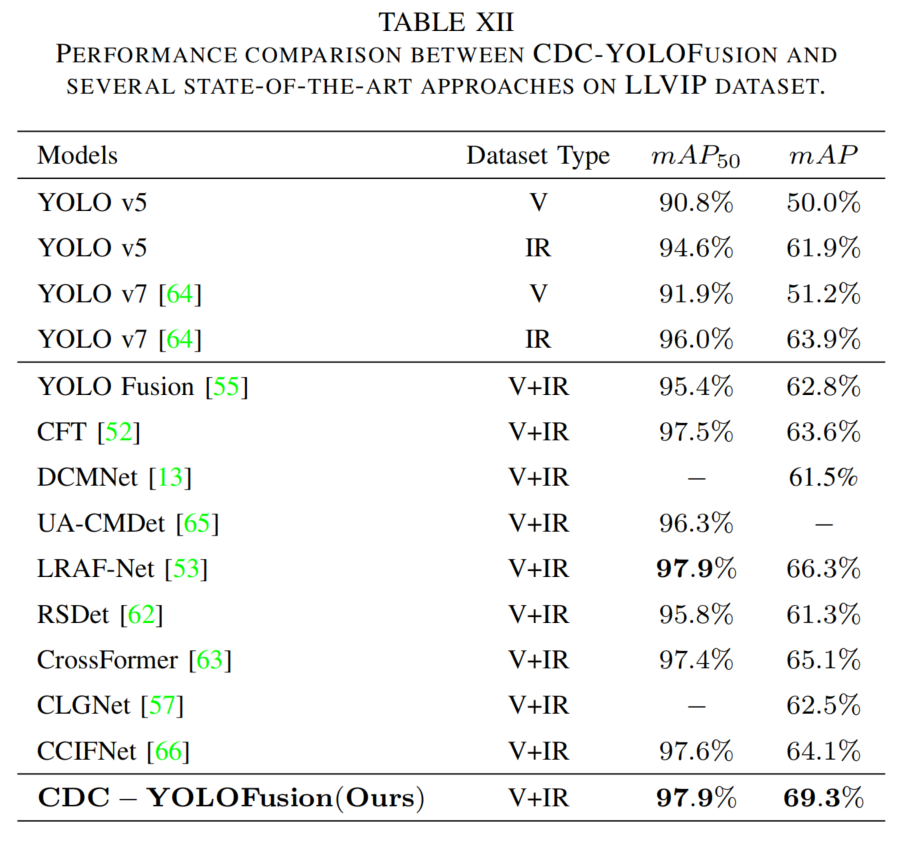
表12 LLVIP数据集上的性能比较
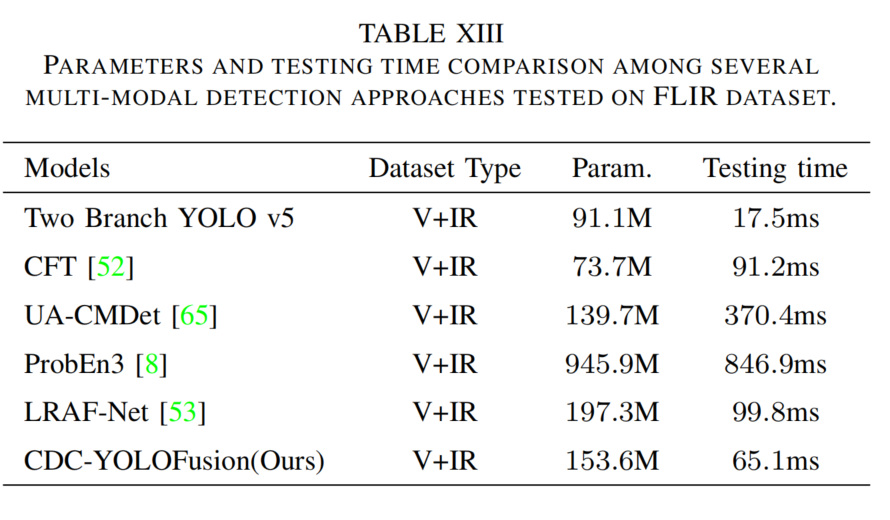
表13比较模型参数和推理时间,CDC-YOLOFusion在参数(153.6 M)和推理时间(65.1 ms)上平衡良好,优于LRAF-Net等方法。
表13 FLIR数据集上多模态检测方法的参数和测试时间比较
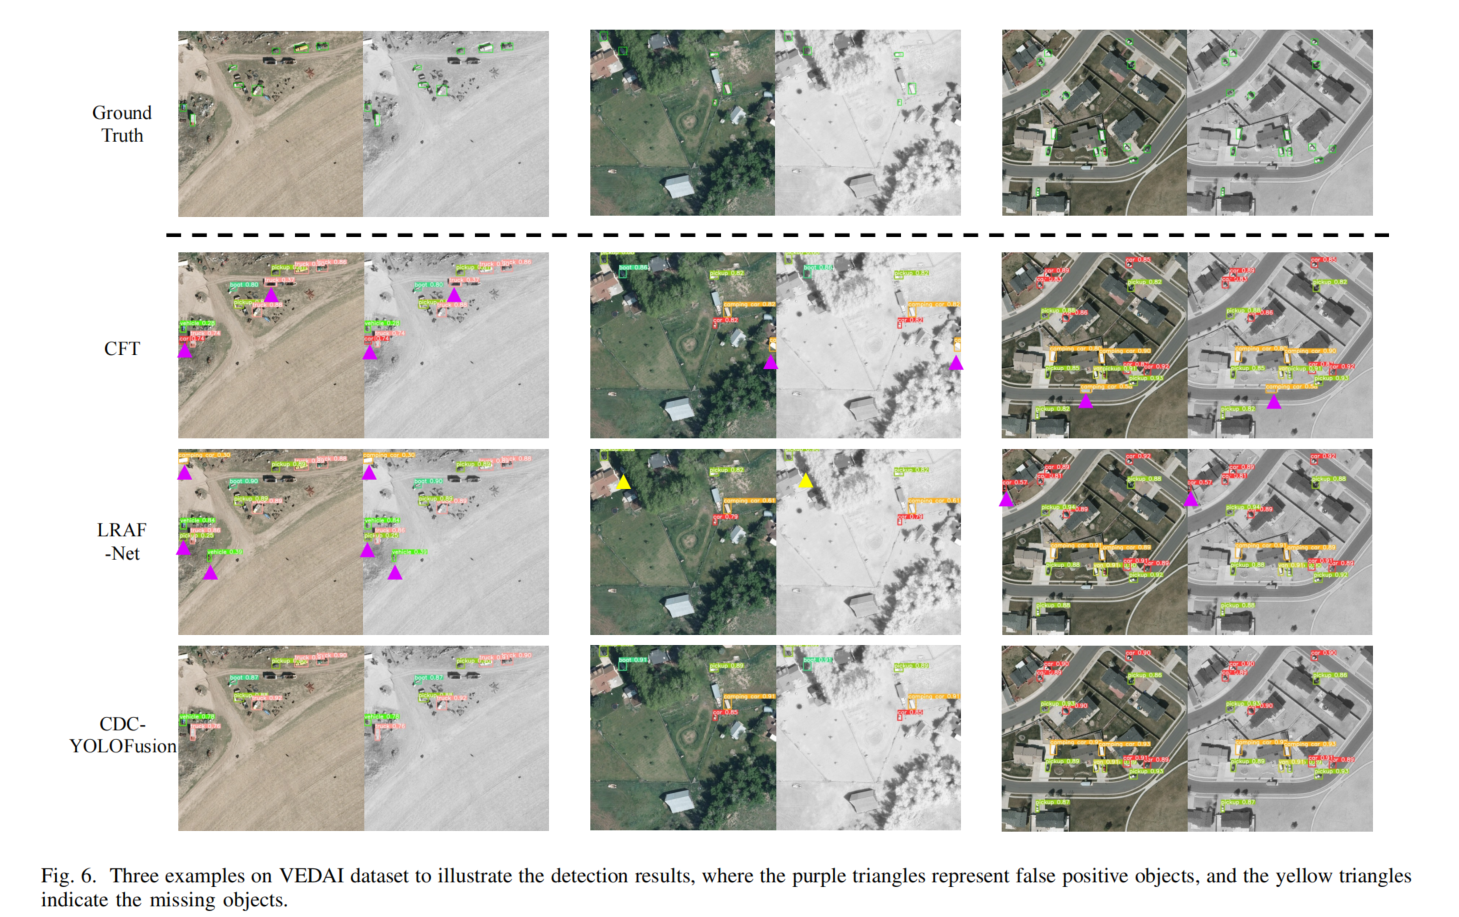
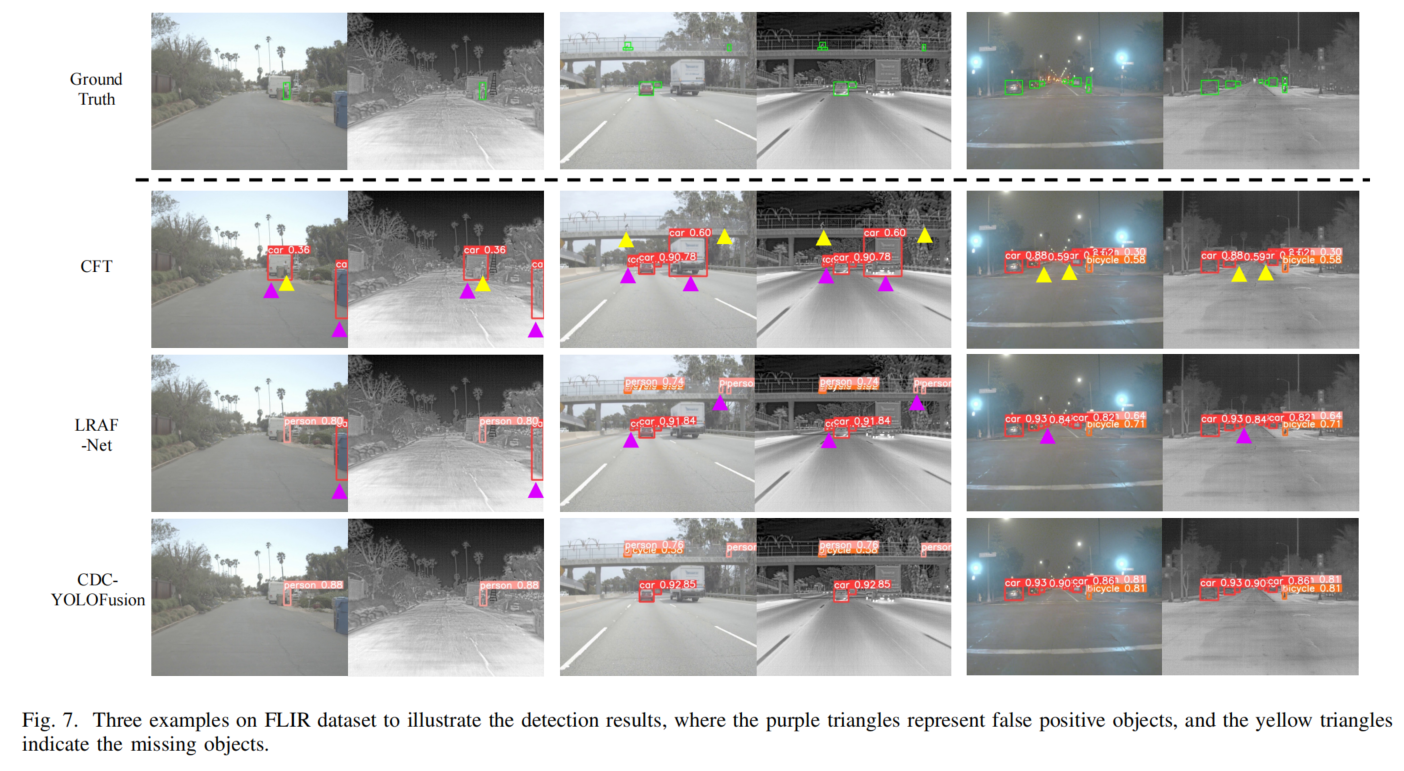
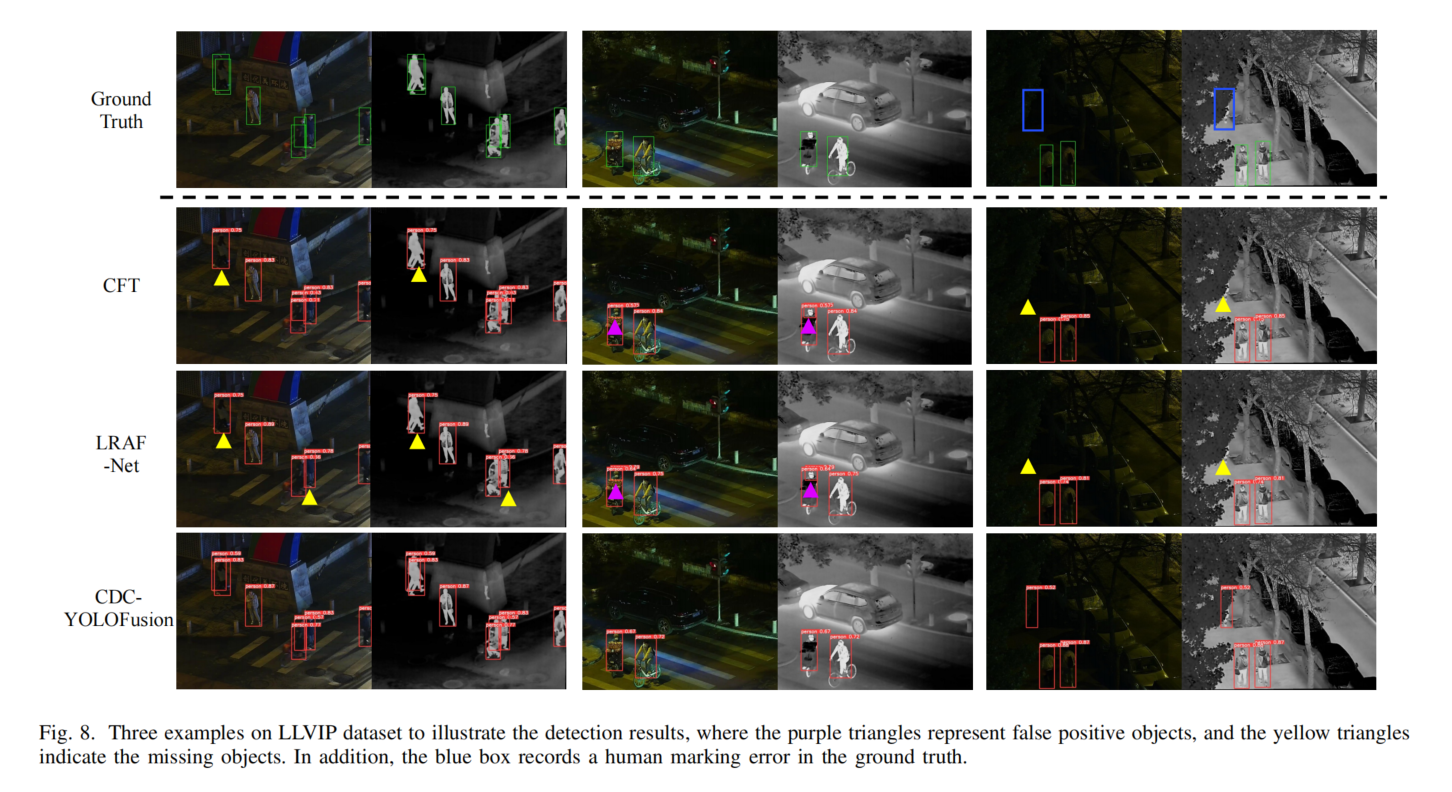
图6-8展示检测结果示例,CDC-YOLOFusion在小目标检测、易混淆目标识别、密集及遮挡场景中表现优异,因CSFE利用跨尺度特征、CDS和DDCF提供模态相关信息、KI损失引导特征提取。
06 个人声明
本文为作者对原论文的学习笔记与心得分享,受个人学识与理解所限,文中对论文内容的解读或有不够周全之处,一切以原论文正式表述为准。本文仅用于学术交流与传播,内容均由作者独立整理完成,不代表本公众号立场。如文中所涉文字、图片等内容存在版权争议,请及时与作者联系,作者将在第一时间核实并妥善处理。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或赞助支持!
音乐
暂未播放